DB 스키마 공개
· 약 5분

들어가며
스키마 저장소 → https://github.com/SceneMakerAI/sm_db/tree/sbin
이 글에서 다루는 내용은 아래와 같다.
- 테이블 한눈에 보기
- 테이블은 어떻게 이어지나
- 조회하면 무엇이 나오나
- 테이블 이어서 조회하기
- 검색 색인
1. 테이블 한눈에 보기
- 관계형 DB 가 분석 결과의 원본이다. 영상 → 음성 · 인물 · 화면 → 편성 순서로 쌓인다.
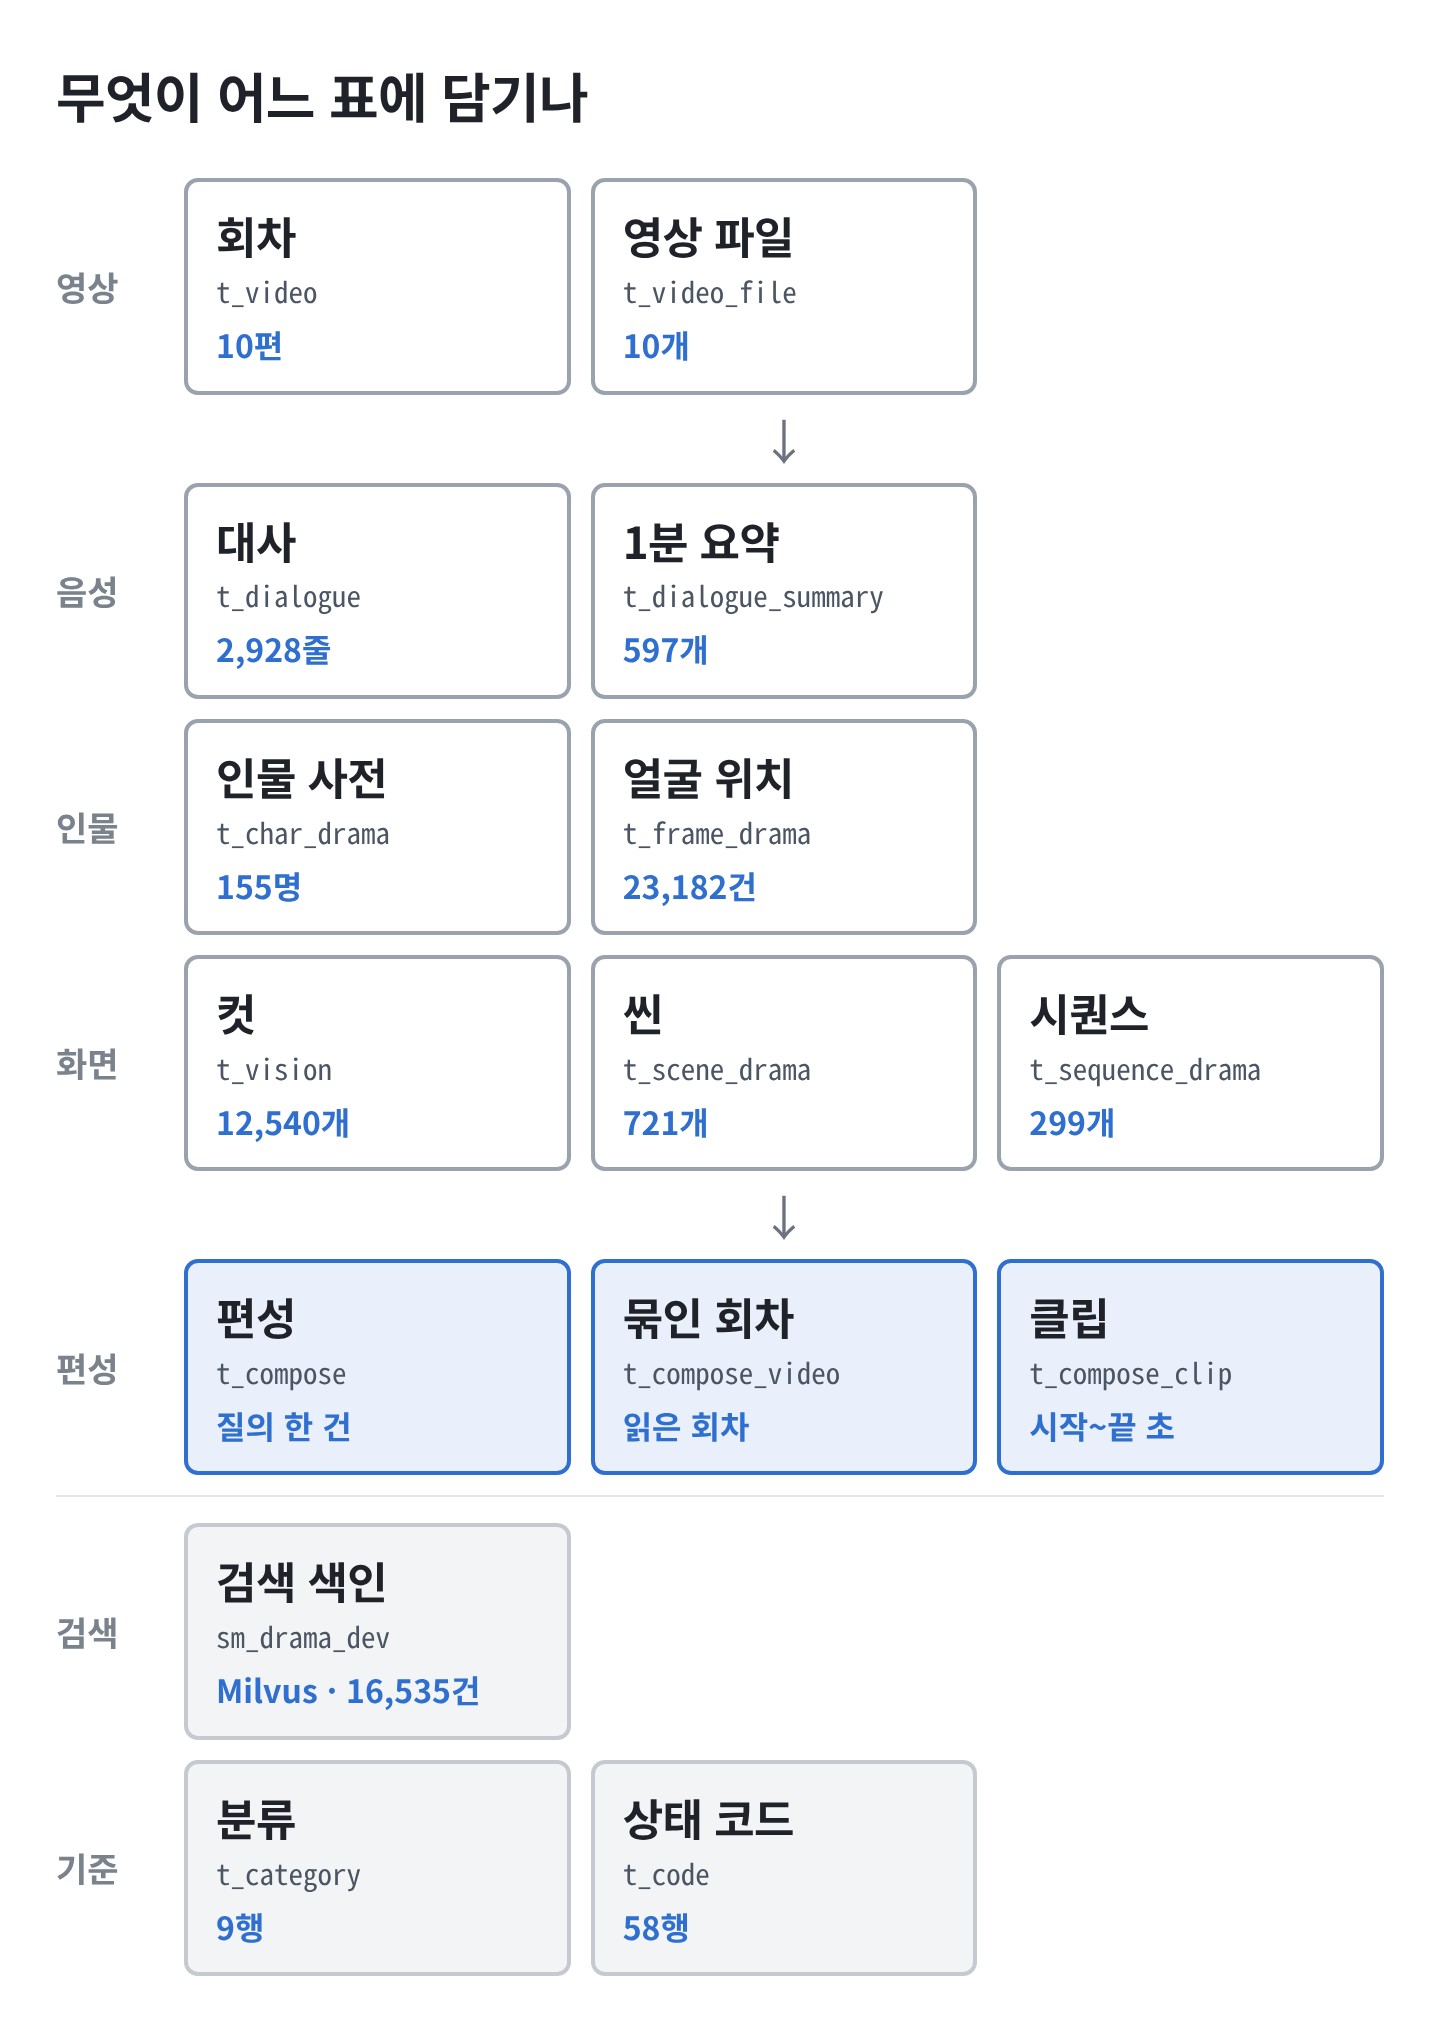
- 테이블마다 한 줄로 소개하면 아래와 같다.
| 표 | 한 행이 뜻하는 것 |
|---|---|
t_video | 회차 한 편 |
t_video_file | 그 회차의 원본 파일과 처리 상태 |
t_dialogue | 대사 한 줄 |
t_dialogue_summary | 대사 1분 구간의 요약 |
t_char_drama | 등장인물 한 명 |
t_frame_drama | 화면에 보인 얼굴 하나 |
t_vision | 컷 하나 — 화면이 한 번 바뀔 때까지 |
t_scene_drama | 씬 하나 — 같은 시간·장소의 한 장면 |
t_sequence_drama | 시퀀스 하나 — 사건 하나 |
t_compose | 편성 한 건 — 질의와 그 결과 |
t_compose_video | 그 편성이 읽은 회차 |
t_compose_clip | 그 편성이 고른 클립 하나 |
t_category · t_code | 분류와 상태 코드 |
- 테이블은 모두 15개다. 나머지 하나(
t_chapter)는 예비 표라 드라마 분석에서는 쓰지 않는다.
2. 테이블은 어떻게 이어지나
- 테이블을 잇는 값은 네 가지다.
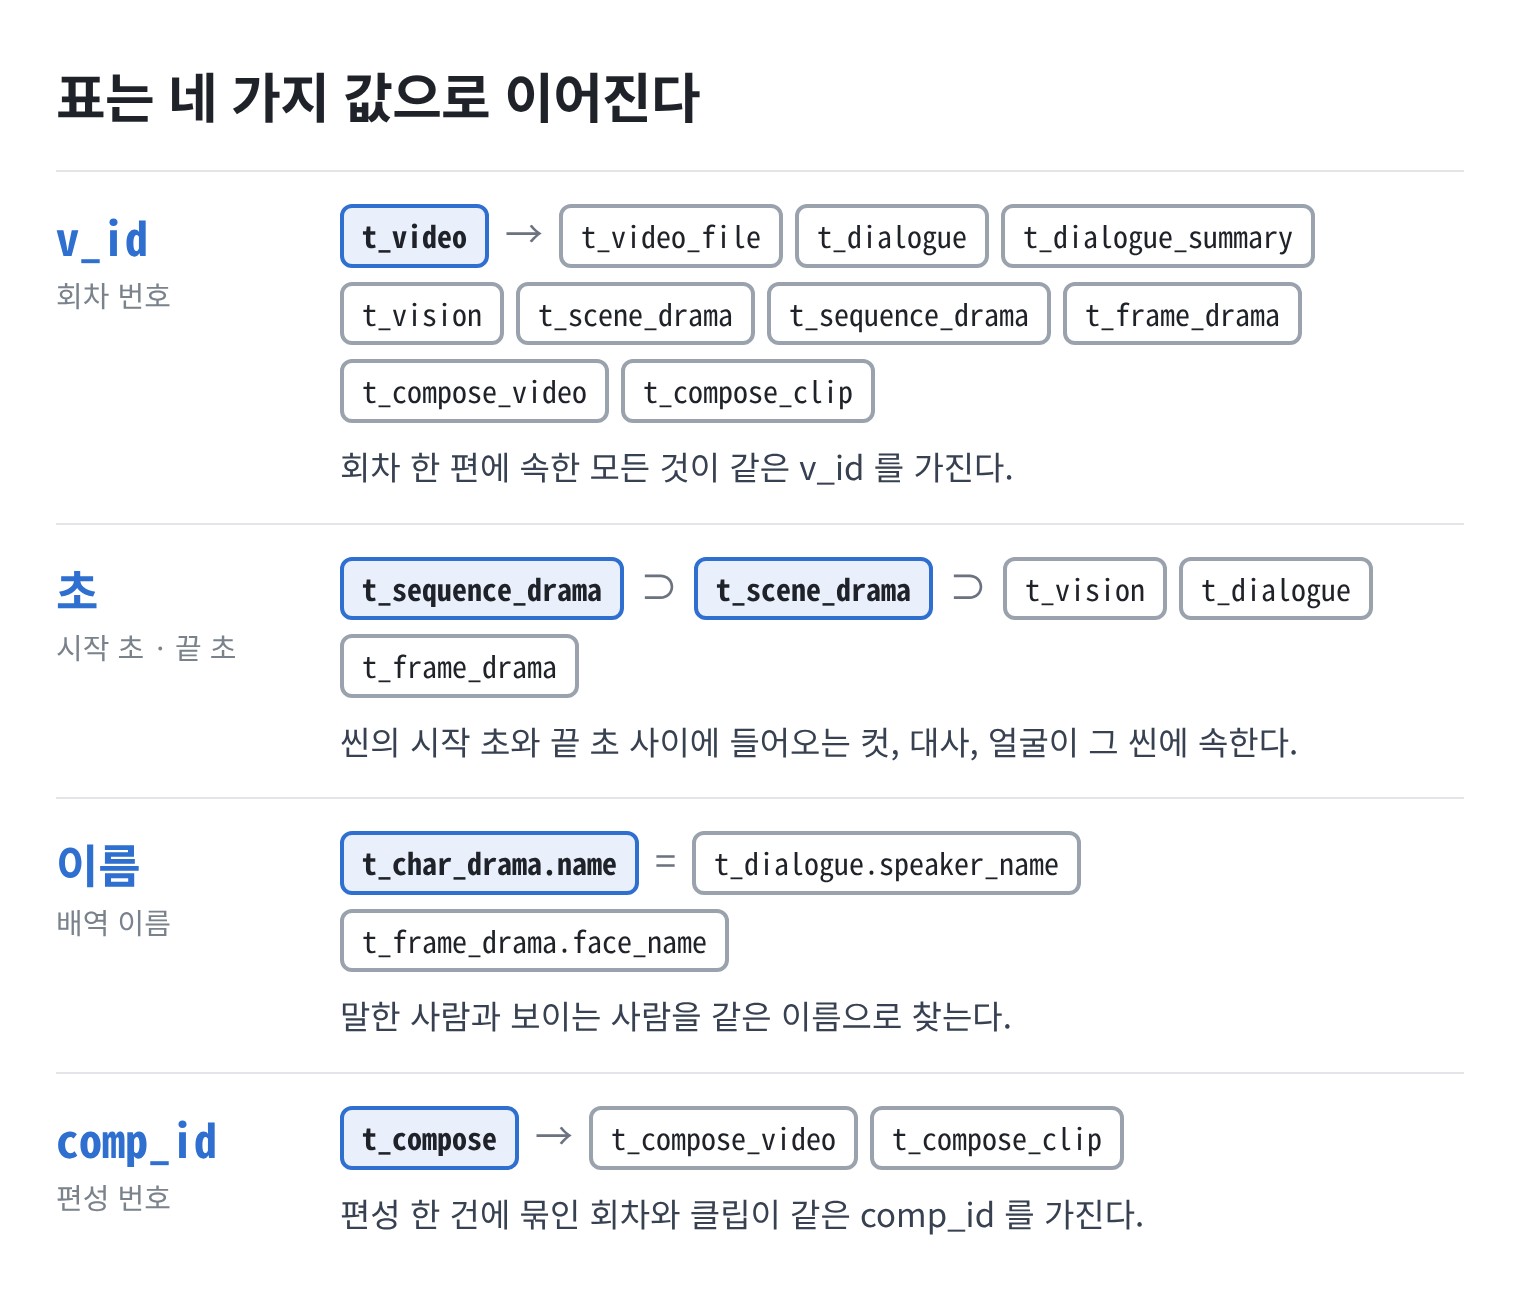
- 이 가운데 초 가 가장 많이 쓰인다. 씬에 대사가 몇 번부터 몇 번까지인지 적어 두지 않는다. 씬의 시작 초와 끝 초 사이에 들어오는 대사가 그 씬의 대사다.
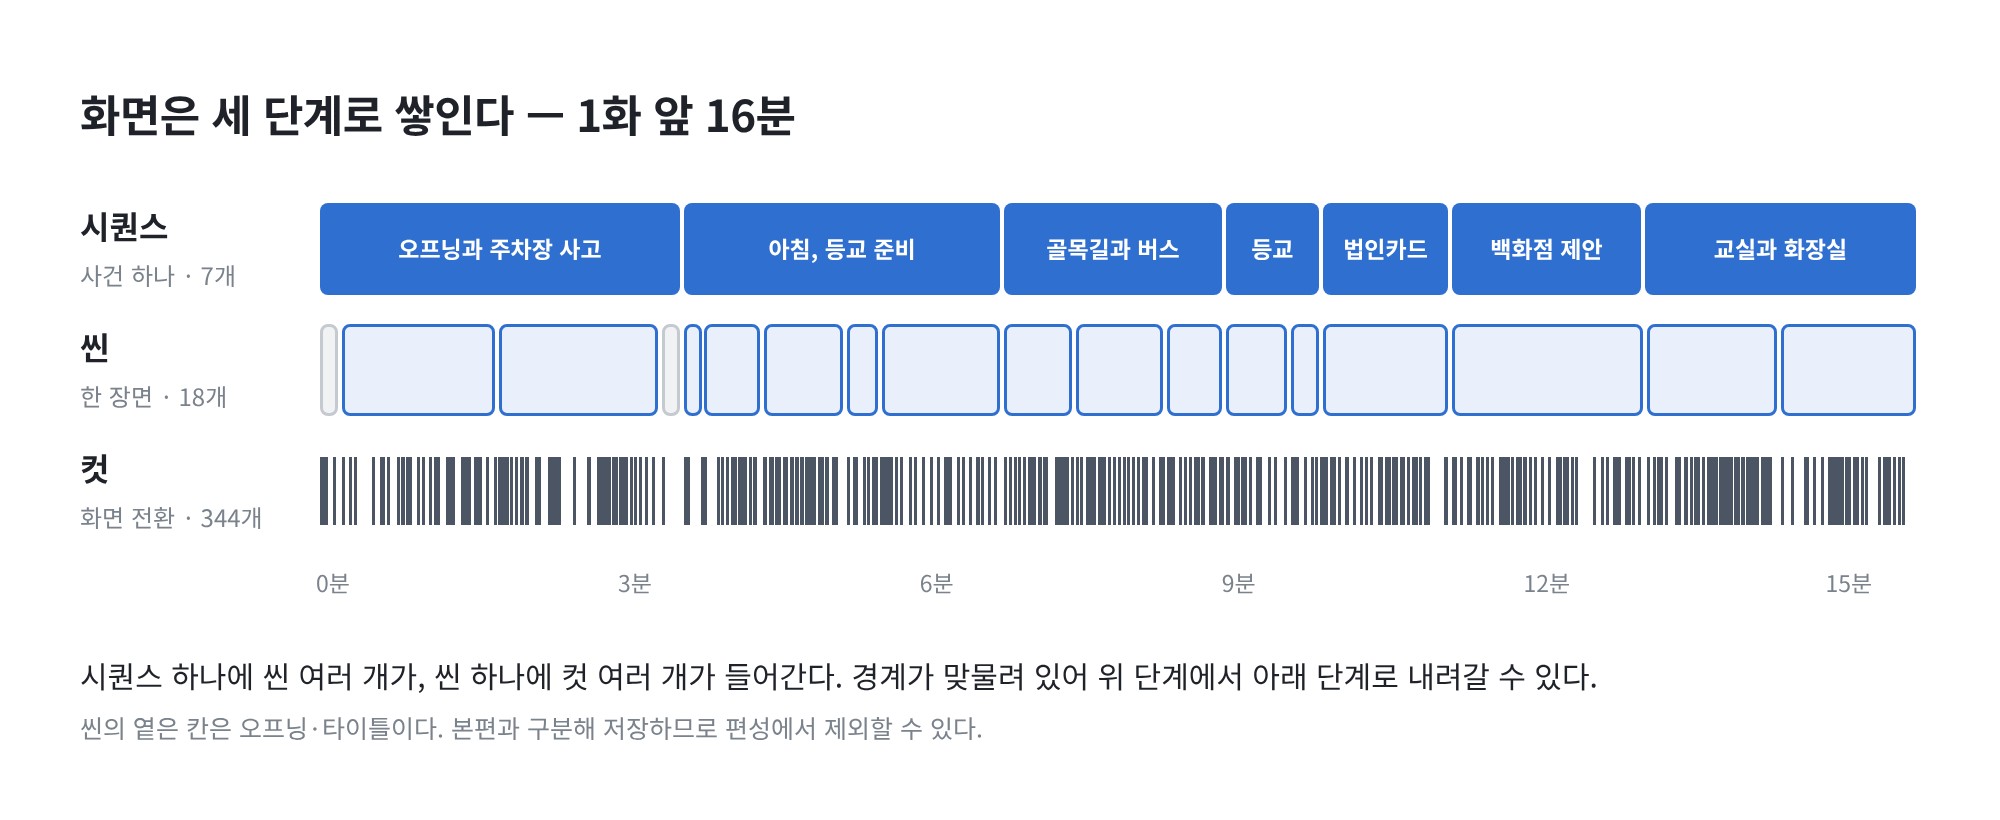
- 화면 쪽 표 세 개는 이 방식으로 층을 이룬다. 시퀀스 안에 씬이, 씬 안에 컷이 들어간다.
3. 조회하면 무엇이 나오나
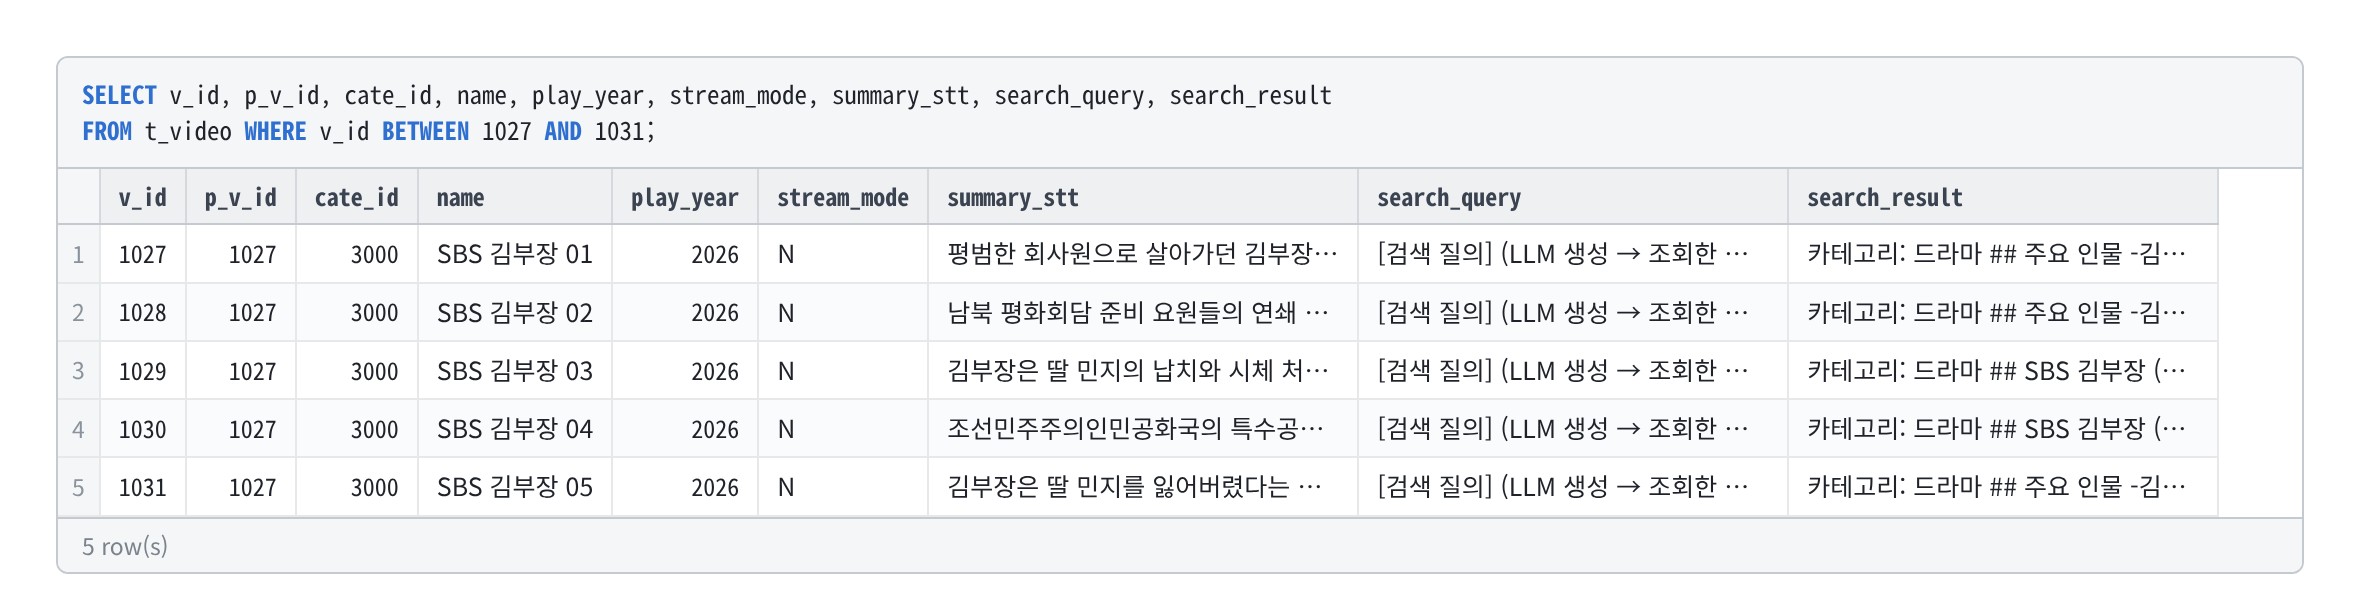
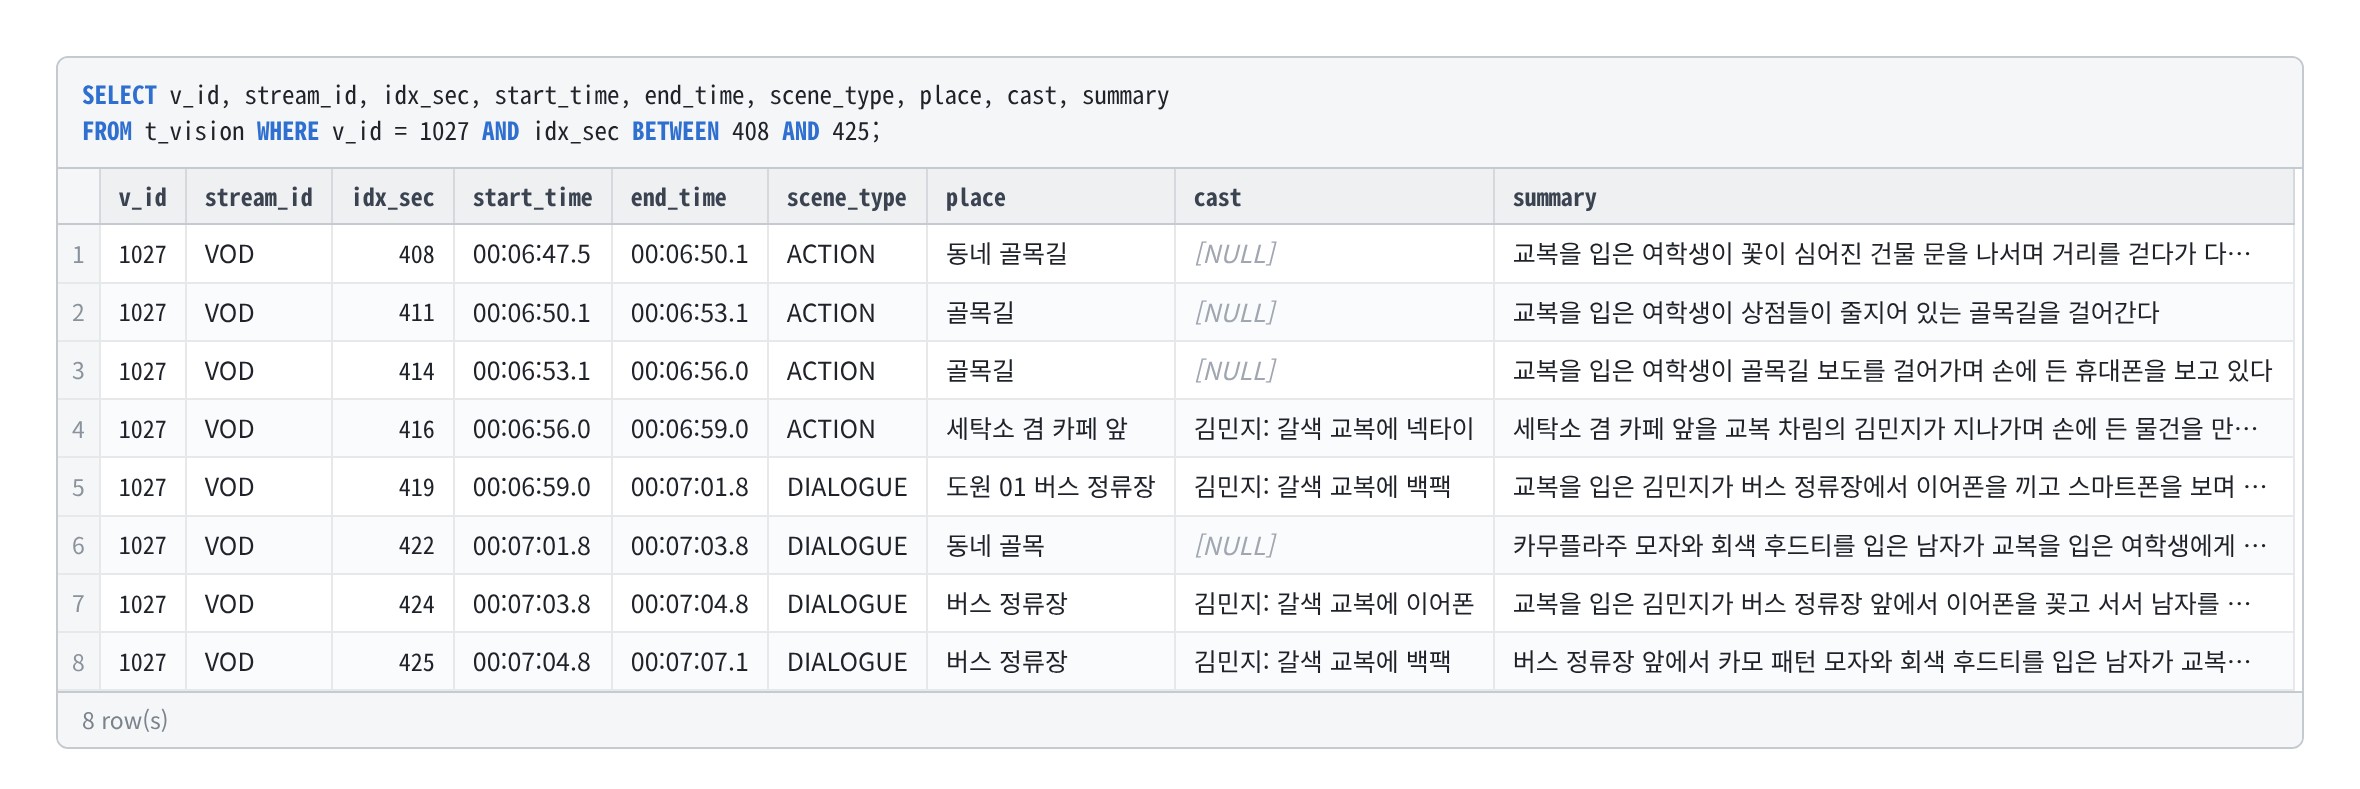
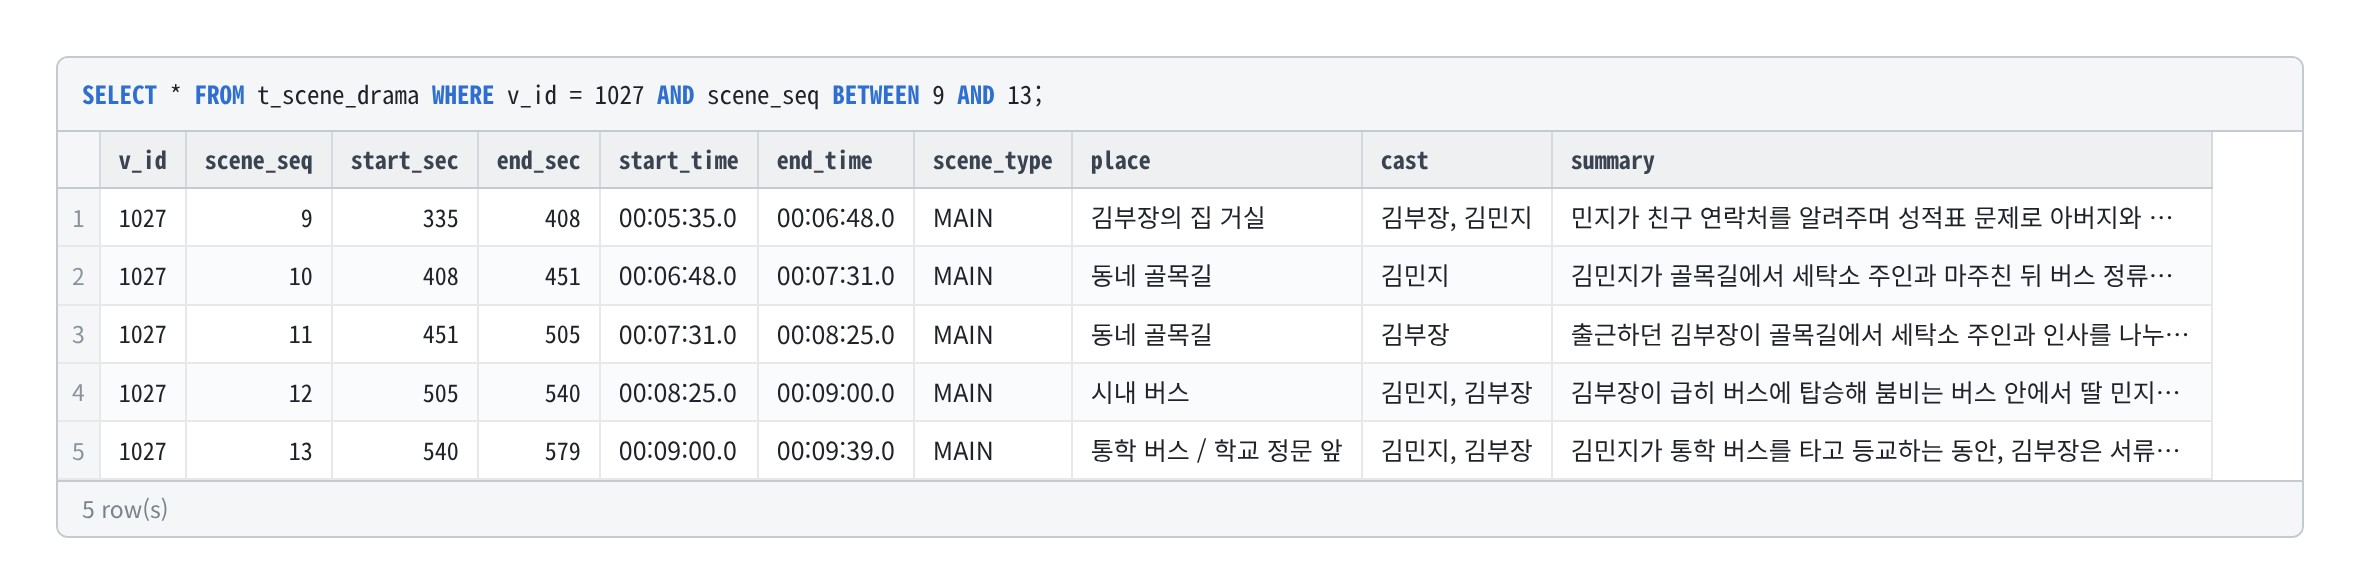
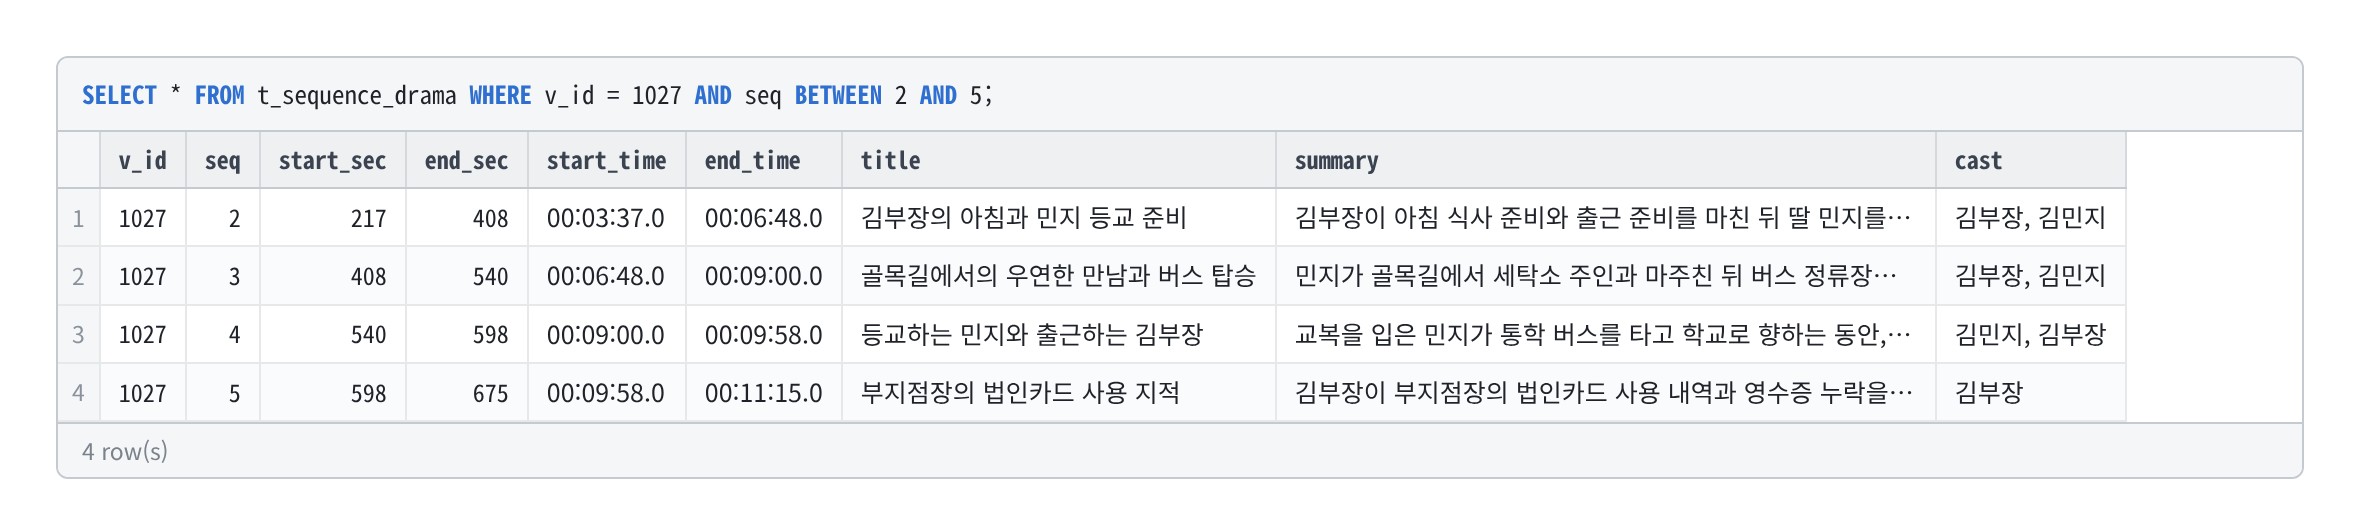
실제 DB 에서 조회한 결과다. 1화(v_id = 1027 )의 6분 48초 무렵, 주인공의 딸이 등굣길에 골목을 지나 버스를 타는 대목을 표마다 꺼냈다.
3-1. 회차 — t_video
- 회차 한 편이 한 행이다. 열 편이 같은 드라마 묶음 번호(
p_v_id)를 가진다. - 대사로 만든 줄거리와, 웹에서 찾은 배역 명단이 함께 들어 있다.
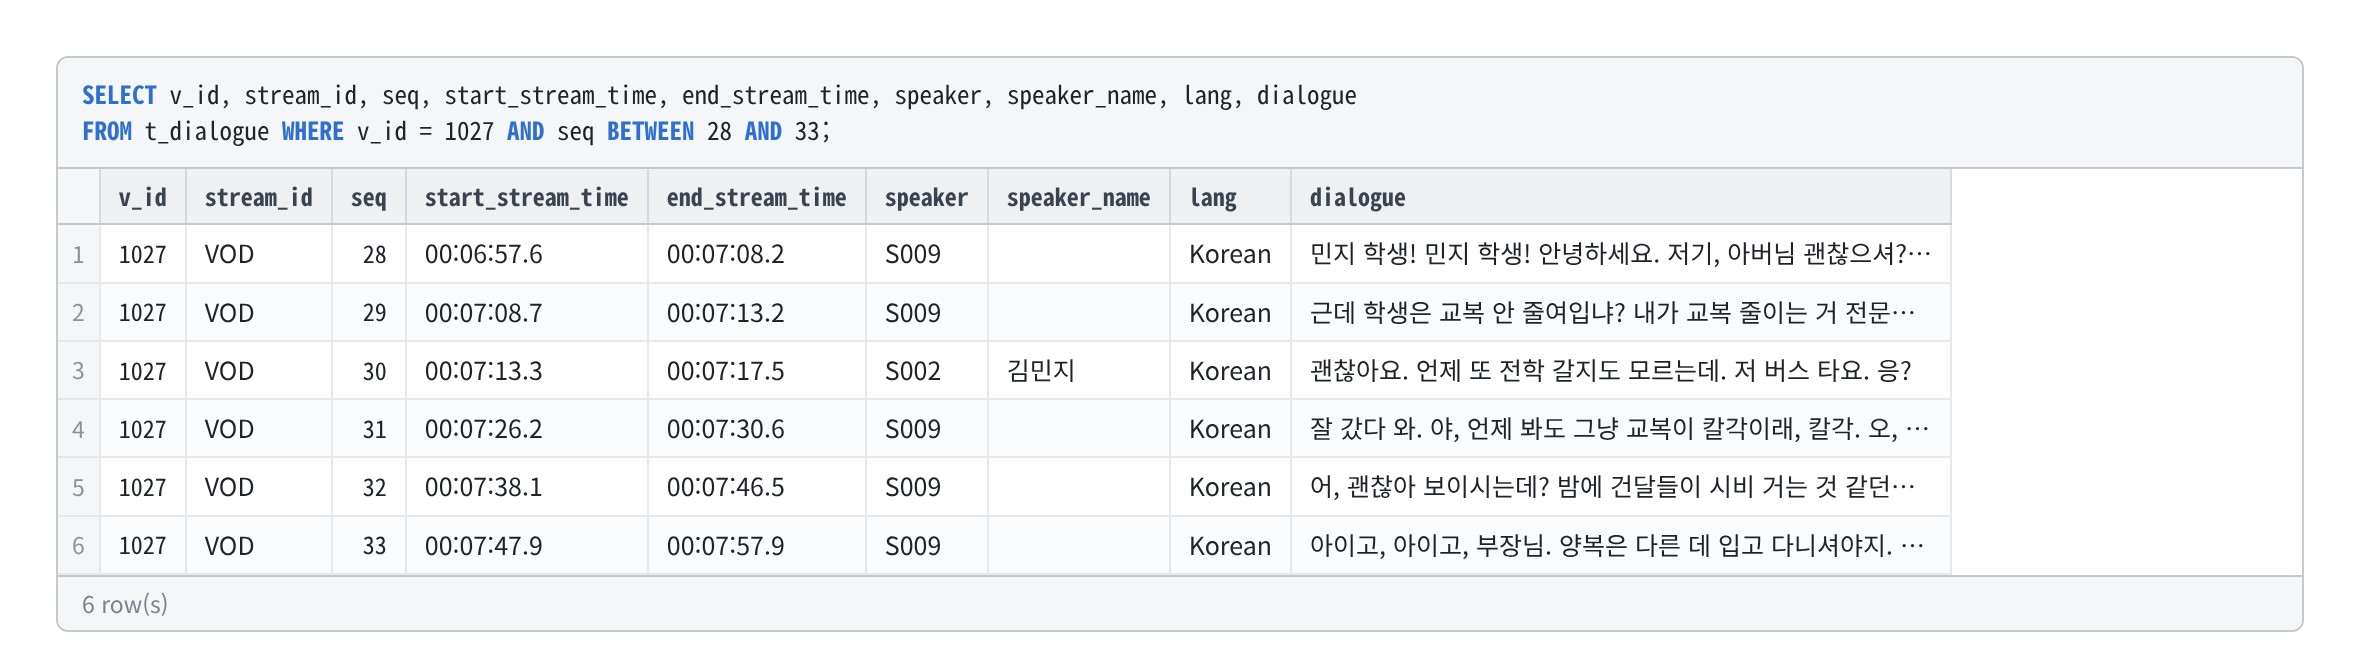
3-2. 대사 — t_dialogue
- 대사 한 줄이 한 행이다. 시작·끝 시각과 화자가 붙는다.
speaker는 목소리로 구분한 번호이고,speaker_name은 그 뒤 단계에서 붙인 이름이다. 이름이 확인되지 않은 화자는 비어 있다.
3-3. 1분 요약 — t_dialogue_summary
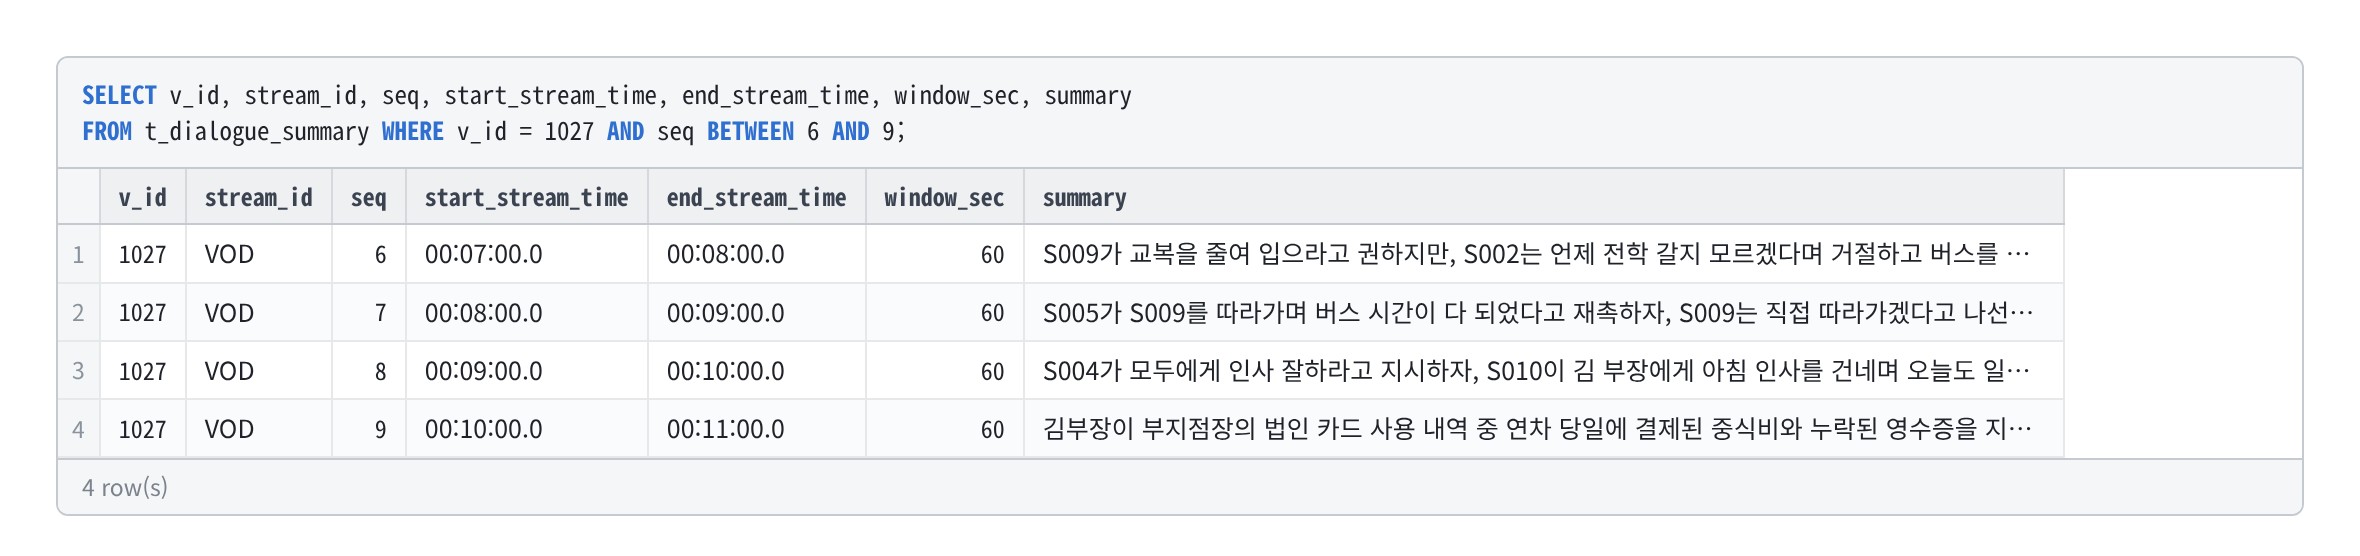
- 대사를 1분씩 끊어 요약한 것이다. 회차를 사건 단위로 나눌 때 재료가 된다.
3-4. 인물 사전 — t_char_drama
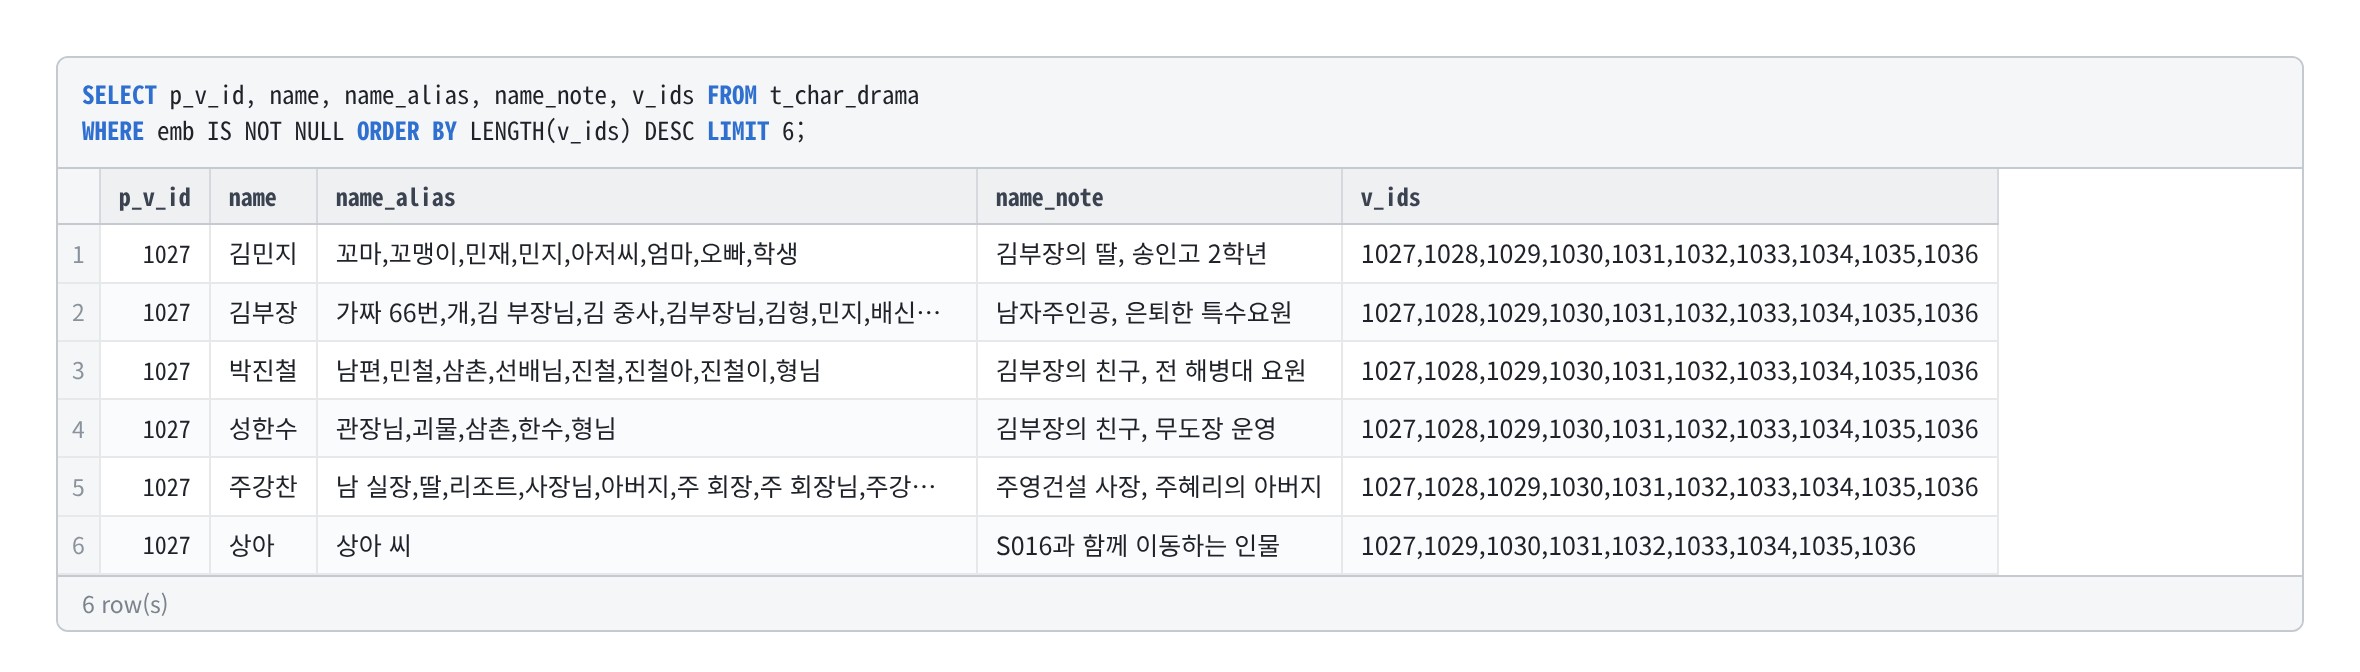
- 등장인물 한 명이 한 행이다. 이름, 호칭, 설명, 등장 회차가 들어 있다.
- 호칭을 함께 적는 것은 드라마에서 이름보다 "삼촌", "부장님" 으로 부르는 경우가 많기 때문이다.
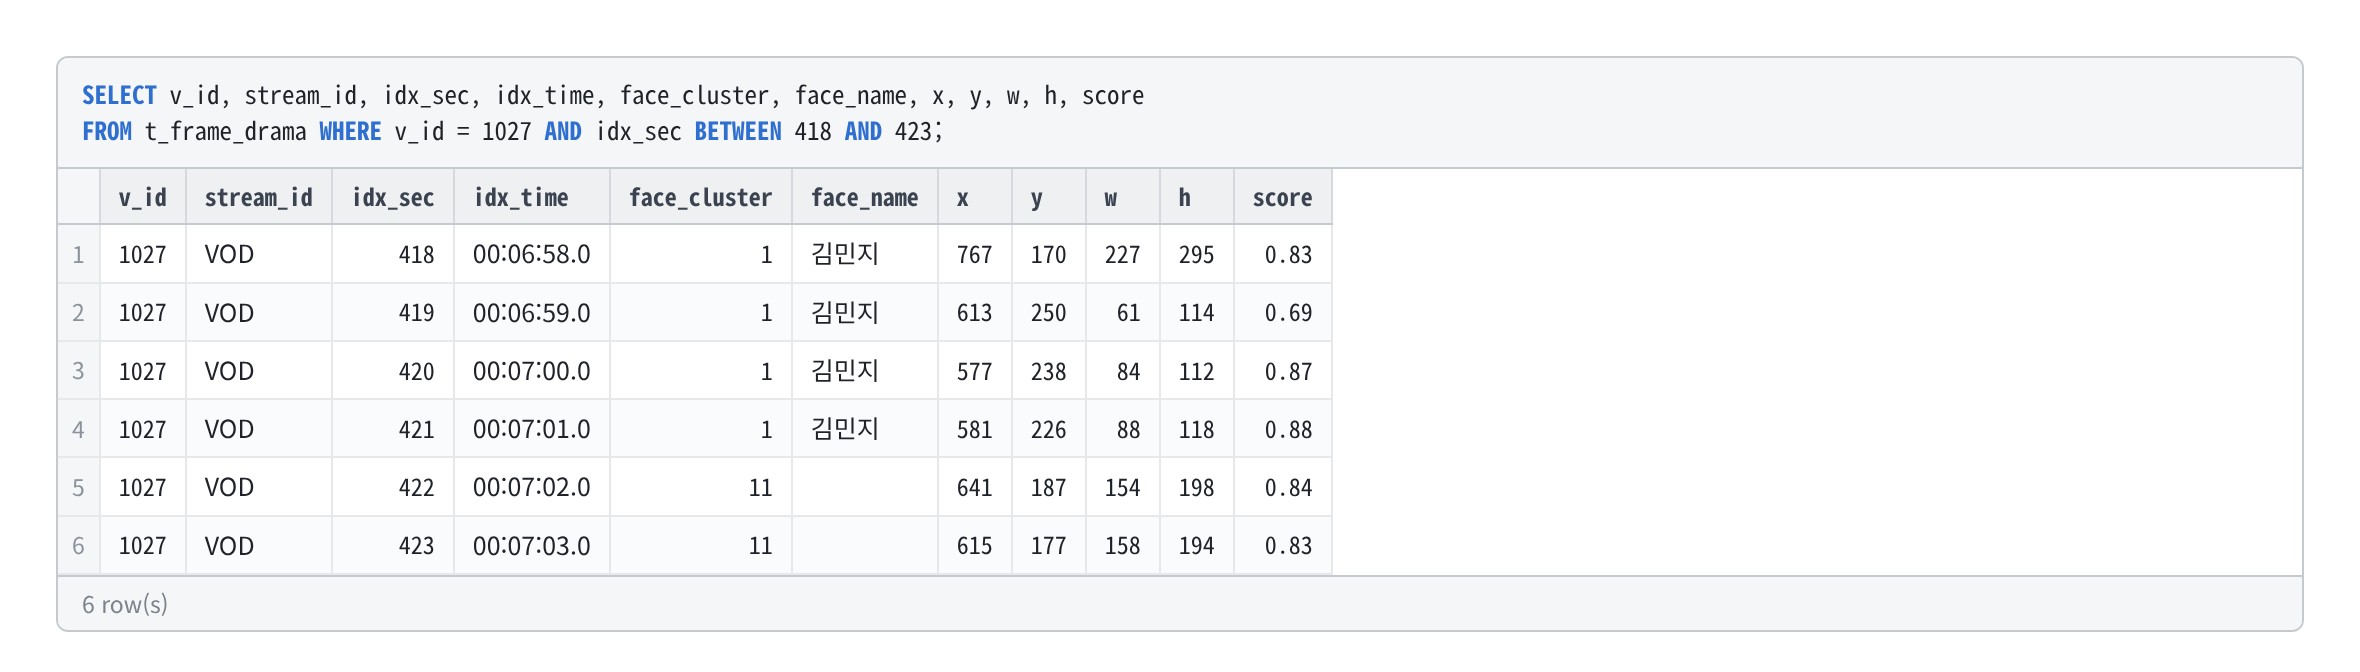
3-5. 얼굴 위치 — t_frame_drama
- 1초마다 뽑은 화면에서 찾은 얼굴 하나가 한 행이다. 몇 초에, 화면 어디에, 누구인지가 들어 있다.
3-6. 컷 — t_vision
- 화면이 한 번 바뀔 때까지가 한 행이다. 평균 3초다.
- 화면을 보고 판정한 유형, 장소, 보이는 인물, 한 줄 설명이 붙는다.
3-7. 씬 — t_scene_drama
- 같은 시간·장소에서 이어지는 한 장면이 한 행이다. 편성이 고르는 단위가 이 씬이다.
- 유형(
scene_type)으로 본편과 오프닝·광고·예고를 구분한다.
3-8. 시퀀스 — t_sequence_drama
- 사건 하나가 한 행이다. 제목과 요약이 붙는다.
3-9. 편성 — t_compose · t_compose_video · t_compose_clip
- 질의 한 줄을 받아 클립 목록을 만든 결과다. 한 건이 표 세 개에 나뉜다.
-
편성에는 질의, 목표 분량, 결과 길이, 클립 수가 들어간다.
-
묶인 회차에는 그 편성이 읽은 회차가 한 행씩 들어간다.
-
클립에는 재생 순서, 회차, 시작 초와 끝 초가 들어간다.
-
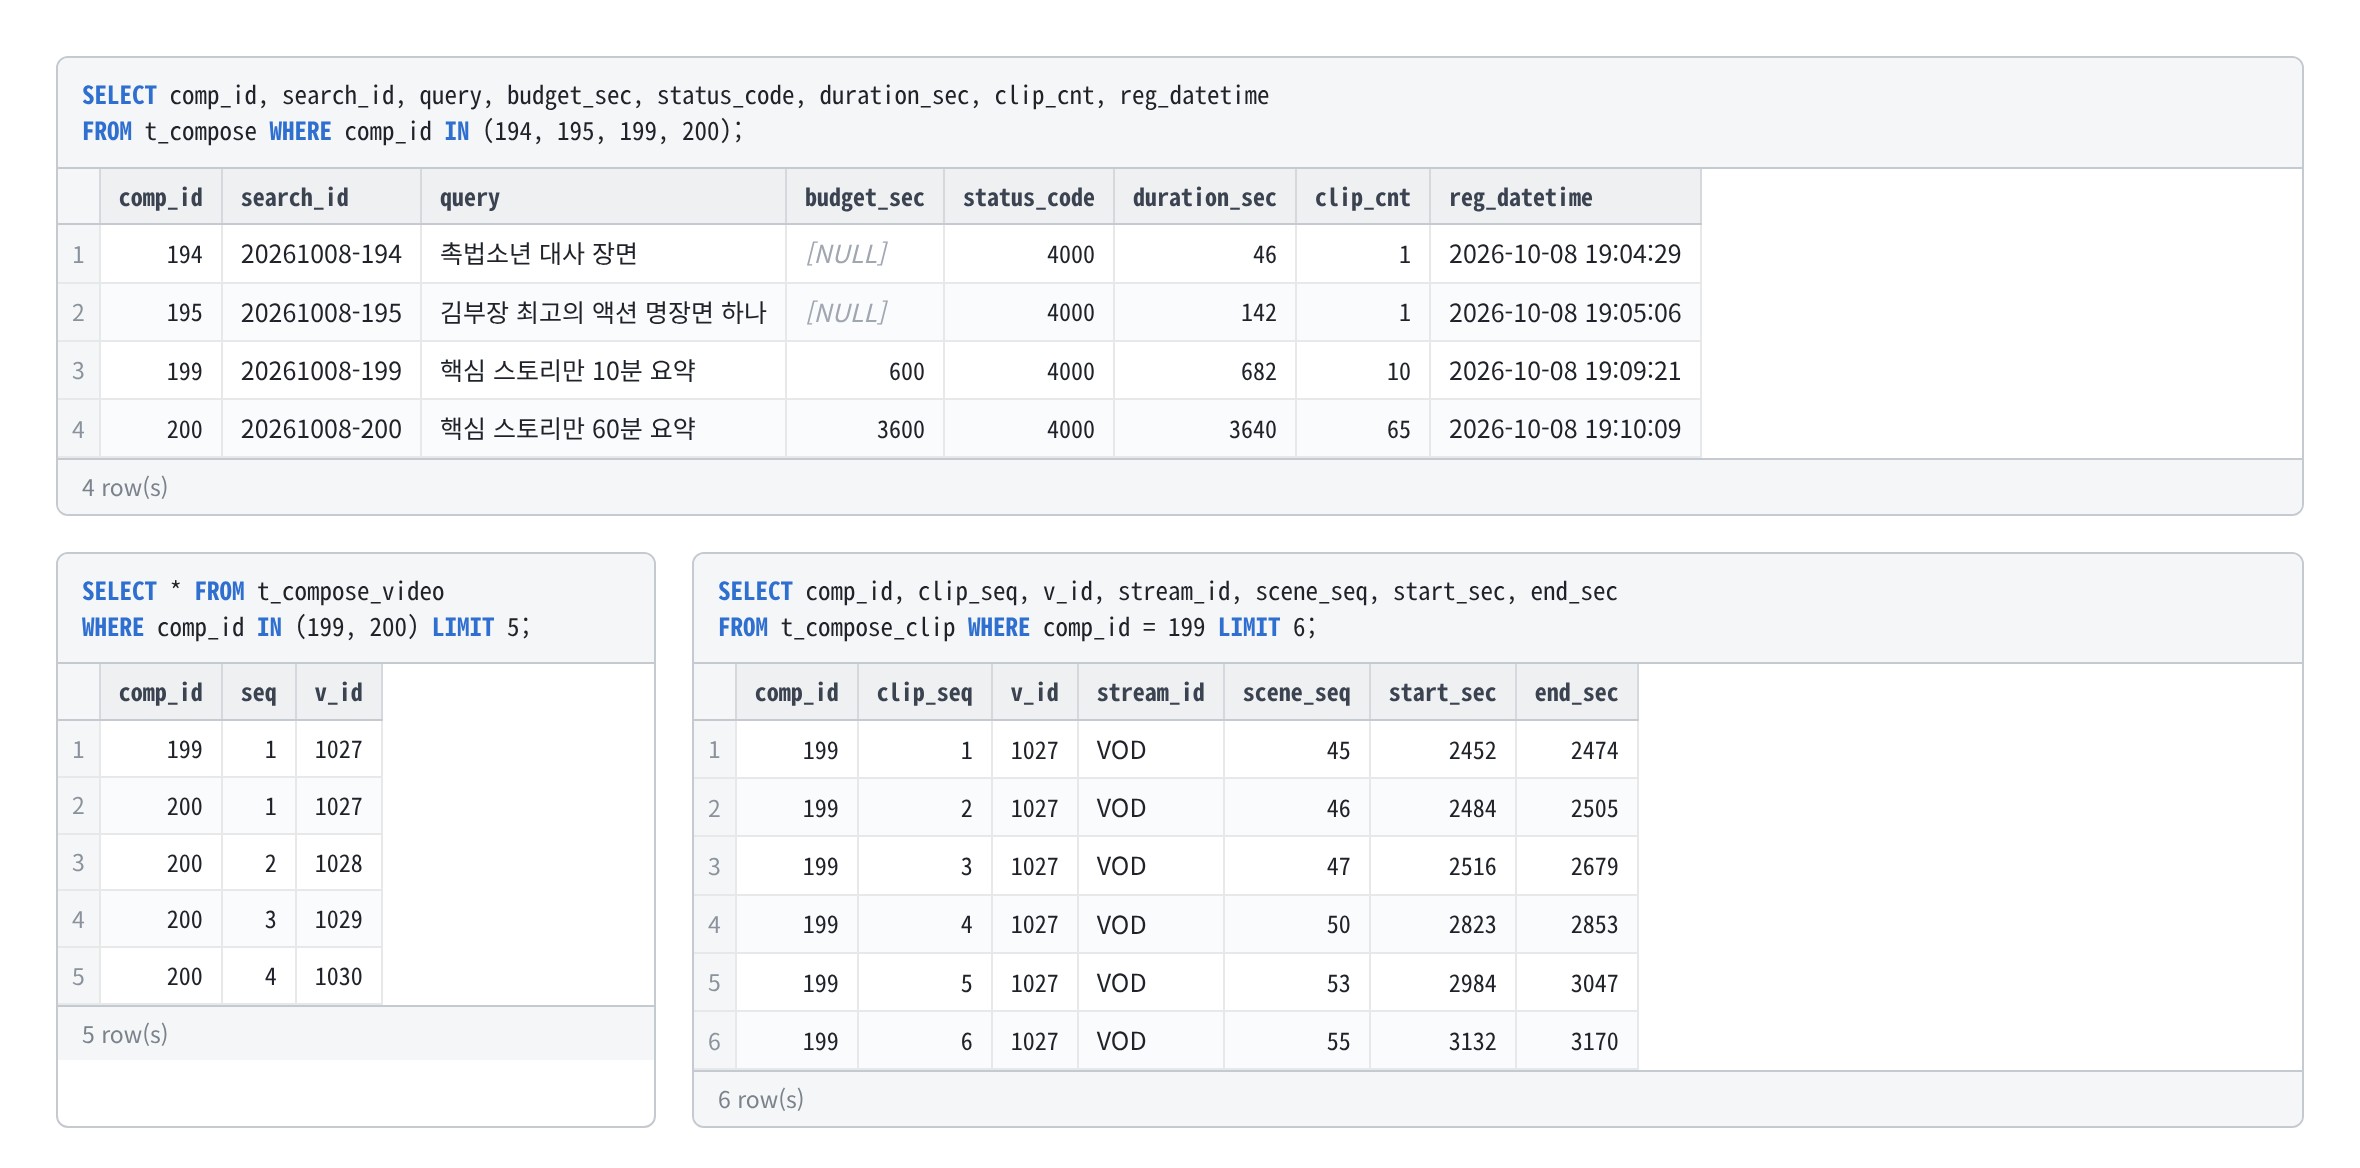
- 클립은 영상 조각이 아니라 좌표 다. 영상으로 합칠 때 이 좌표대로 원본에서 잘라 온다.
4. 테이블을 이어서 조회하기
- 2절의 연결 값을 쓰면 표를 이어 조회할 수 있다.
- 아래는 1화 10번 씬에 들어 있는 대사를 꺼낸 것이다. 회차 번호가 같고, 대사의 시작 초가 씬의 시작 초와 끝 초 사이에 있는 것을 고른다.
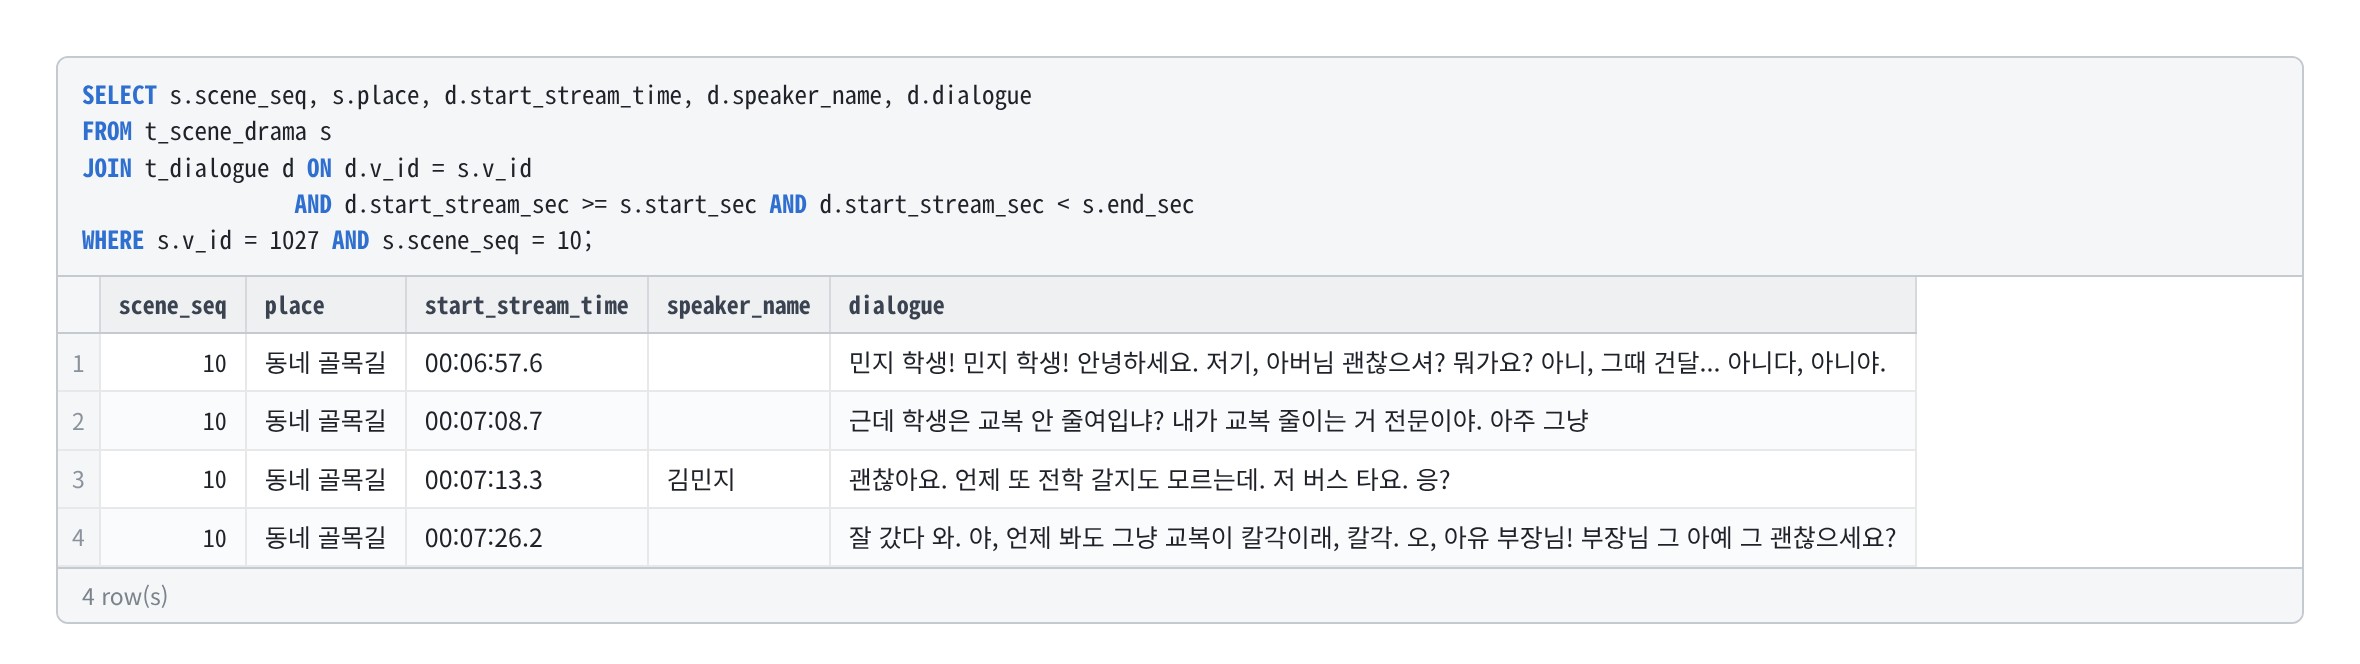
- 같은 방식으로 씬의 컷, 씬에 보인 얼굴, 클립이 나온 씬을 꺼낼 수 있다.
- 클립이 씬 번호와 별도로 시작 초와 끝 초를 직접 가지는 것도 이 때문이다. 씬을 다시 묶으면 씬 번호는 새로 매겨지지만 초는 바뀌지 않는다.
5. 검색 색인
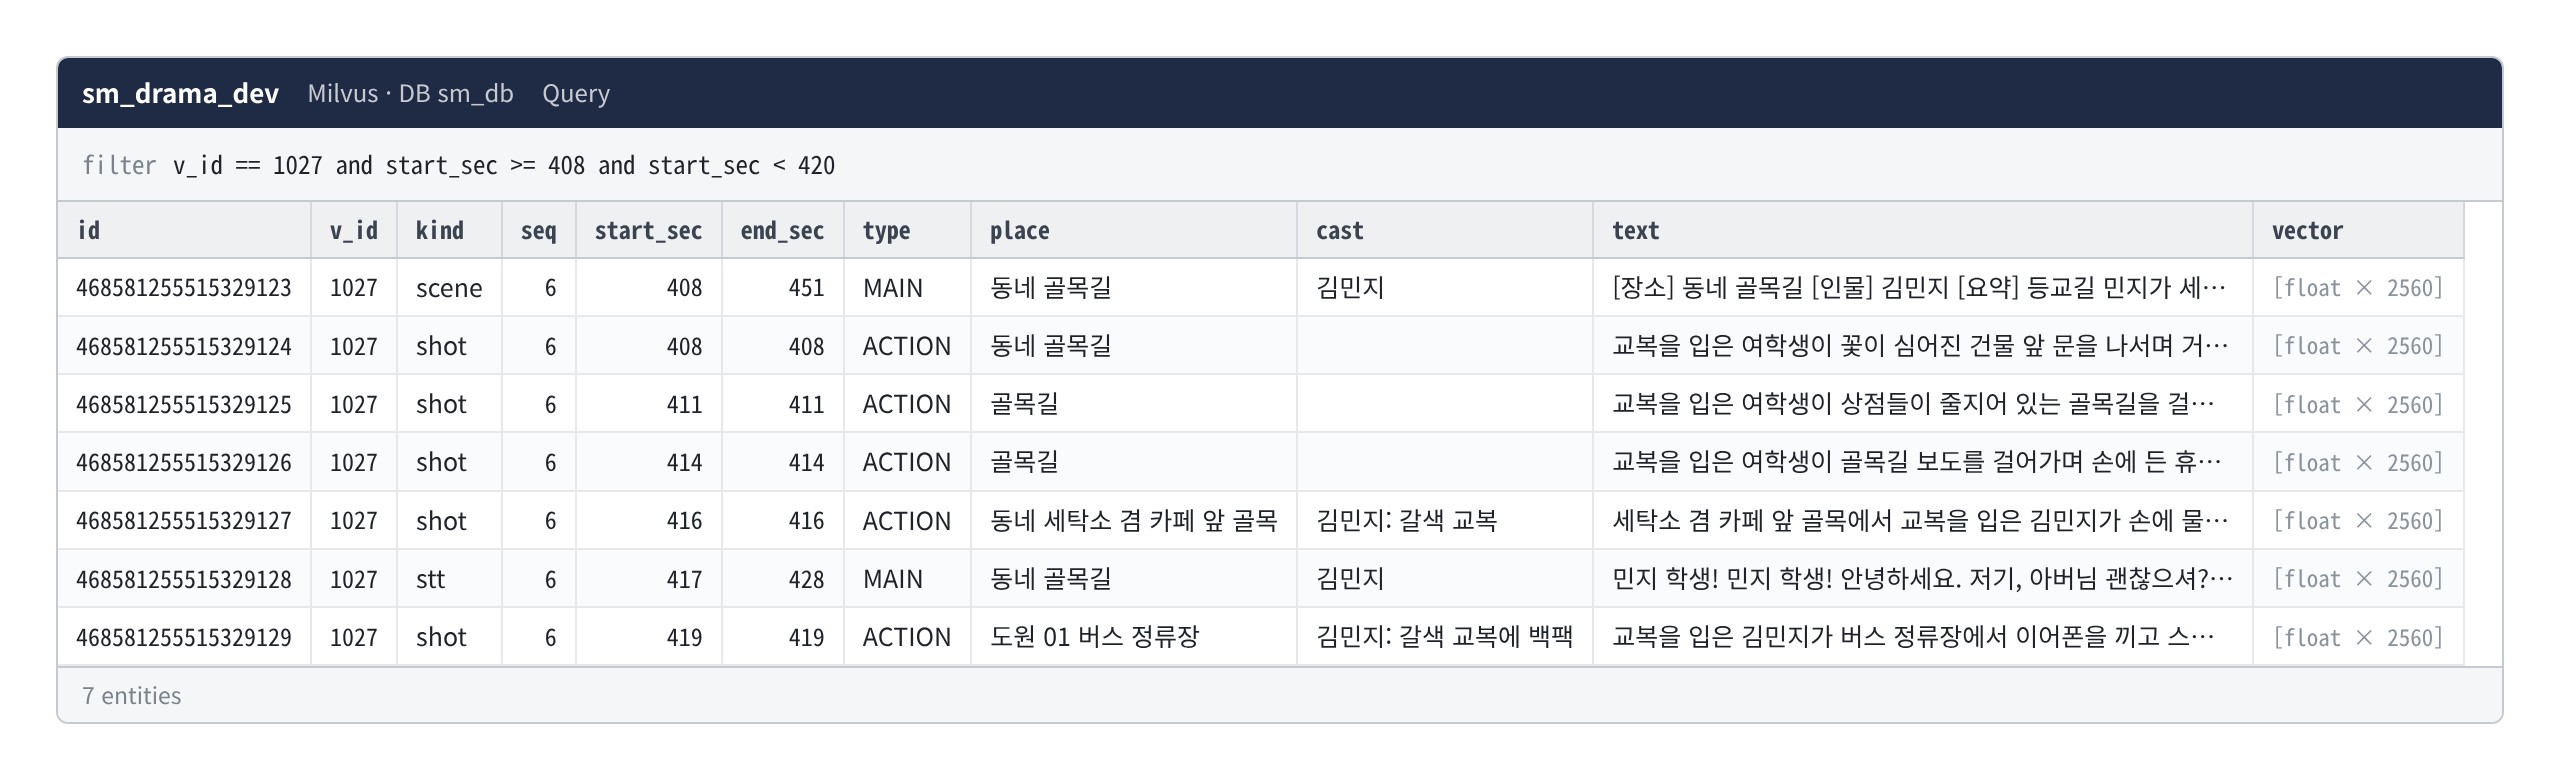
- 질의와 비슷한 장면을 찾기 위해, 관계형 DB 의 글을 벡터로 바꿔 Milvus 에 따로 넣는다.
- 색인을 조회하면 아래와 같이 나온다. 1화 6분 48초 무렵의 씬 요약, 컷 설명, 대사가 한 컬렉션에 함께 들어 있다.
- 벡터로 검색하면 뜻이 가까운 순서로 나온다. 아래는 색인에 든 씬 한 건을 기준으로 가까운 씬을 찾은 결과다.
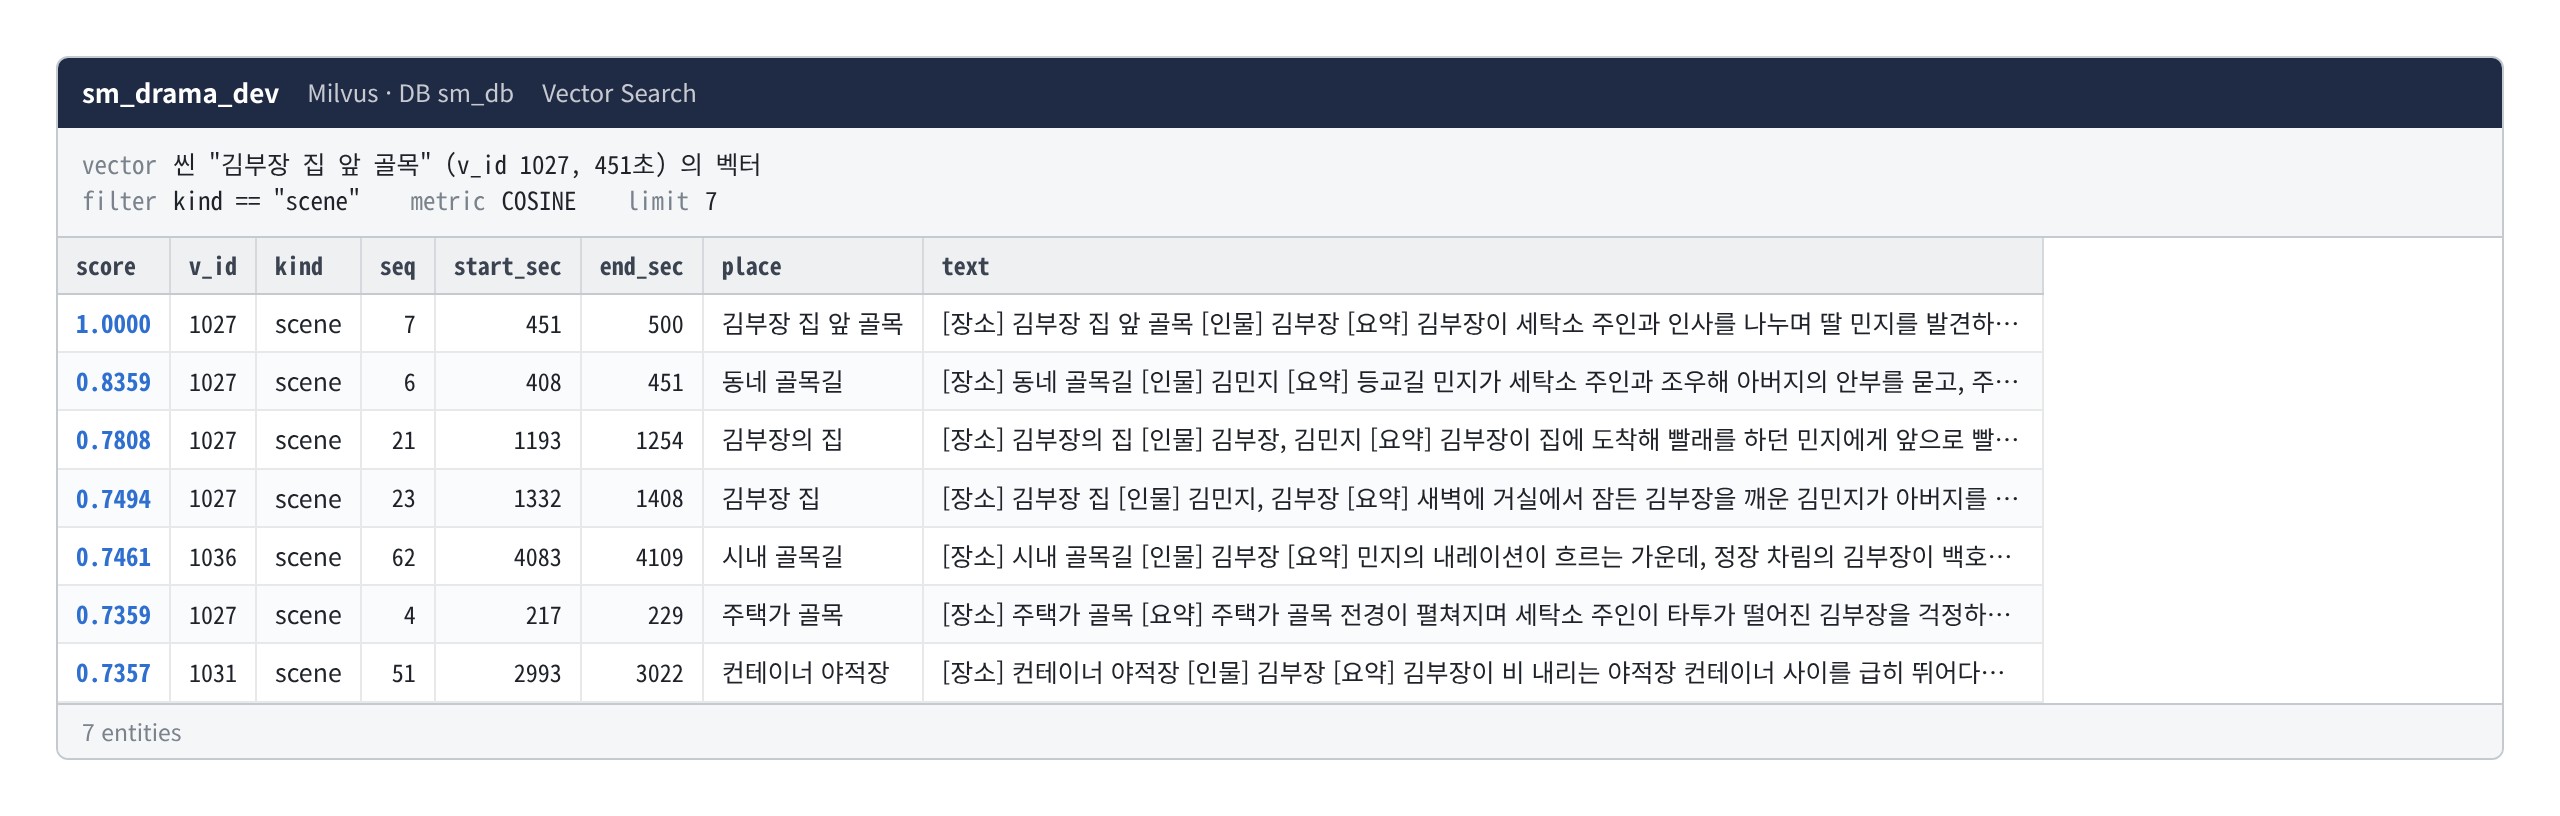
- 다섯 가지 글을 한 컬렉션에 넣는다. 줄거리를 묻든 대사를 묻든 화면을 묻든 한 번에 찾기 위해서다.
- 무엇이 걸리든 회차 번호와 시작·끝 초를 따라 관계형 DB 의 씬으로 돌아간다. 색인의 씬 번호(
seq)는 색인을 만든 시점의 번호라 3절의 씬 번호와 다를 수 있다. - 색인은 관계형 DB 에서 만들어 낸 것이라 지워도 다시 만들 수 있다.
마무리
「김부장」 10편의 분석 결과를 담는 DB 구조를 공개했다.
현재 구성을 정리하면 아래와 같다.
- 관계형 DB 표 15개와 검색 색인 컬렉션 1개로 이루어진다.
- 표는 회차 번호, 초, 이름, 편성 번호로 이어진다.
- 화면은 컷, 씬, 시퀀스의 세 단계로 저장된다.
- 저장소를 받아 명령 한 번으로 같은 구조를 띄울 수 있다.
컬럼의 타입과 키, 기준 데이터 전체는 저장소의 정의 파일에 있다. 구조는 개발하면서 계속 바뀌며, 바뀌면 저장소의 정의도 다시 떠서 맞춘다.
https://github.com/SceneMakerAI/sm_db
참고 링크)
- https://mariadb.com/kb/en/documentation/
- https://milvus.io/docs
- https://huggingface.co/Qwen/Qwen3-Embedding-4B
본 글은 과학기술정보통신부·정보통신산업진흥원 「2026년 오픈소스 AI·SW 개발·활용 지원사업」의 지원으로 수행된 연구 결과입니다.