프로젝트 소개 및 Qwen3.6 방송 도메인 적용기

들어가며
방송사에서 "인물별 모아보기" 영상 1편을 만드는 데 전문 편집자 기준 며칠 이 걸린다. 16부작 드라마의 주요 인물 5명 것을 다 만들려면 수 주일 것이 다.
YouTube Shorts, Reels, TikTok — 플랫폼마다 최적 포맷이 달라 같은 소스로 3번 이상 반복 편집 한다.
광고는 아예 다른 문제다. 현행 VOD 광고 편성은 시간대·장르 같은 메타데이터 기반의 기계적 배정일 것이다.
K-콘텐츠 수요는 폭발하는데, 재가공은 여전히 사람 손에 묶여있다. 병목이 명확하다.
이 글에서는 무엇을 만들고 있고, 어떻게 만들 것이며, 향후 계획을 적어보았다.
1. 무엇을 만드는가
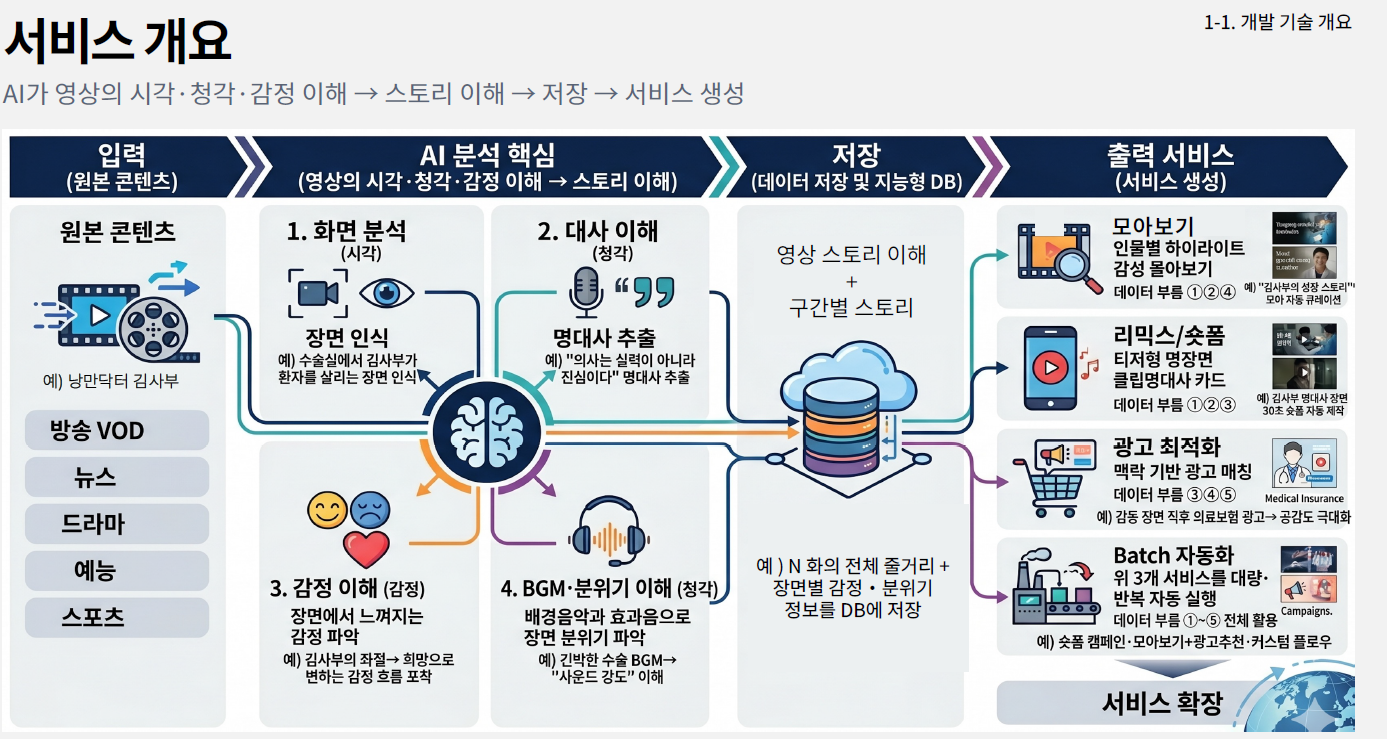
AI에게 영상을 이해시켜, 스토리를 파악하고, 저장한 뒤, 모아보기·리믹스·광고 최적화를 자동 수행하는 서비스
오픈웨이트 모델을 도입하여, RAG와 프롬프트 엔지니어링 으로 방송 도메인에 적응시키기로 했다.
서비스 한 눈에 보면 이와 같다.
| 구축 예정 서비스 | 하는 일 |
|---|---|
| 모아보기 | 정주행 가이드, 인물별 하이라이트, 감성 몽타주 자동 생성 |
| 리믹스 / 숏폼 | 예고편·명장면 클립·명대사 카드, 플랫폼별 자동 변환 |
| 광고 최적화 | 장면 맥락·감정 흐름 기반 최적 광고 삽입 지점 추천 |
| Batch 자동화 | 위 셋을 템플릿화해 대량 콘텐츠 일괄 처리 |
2. 어떻게 만드는가 — 4개의 STEP
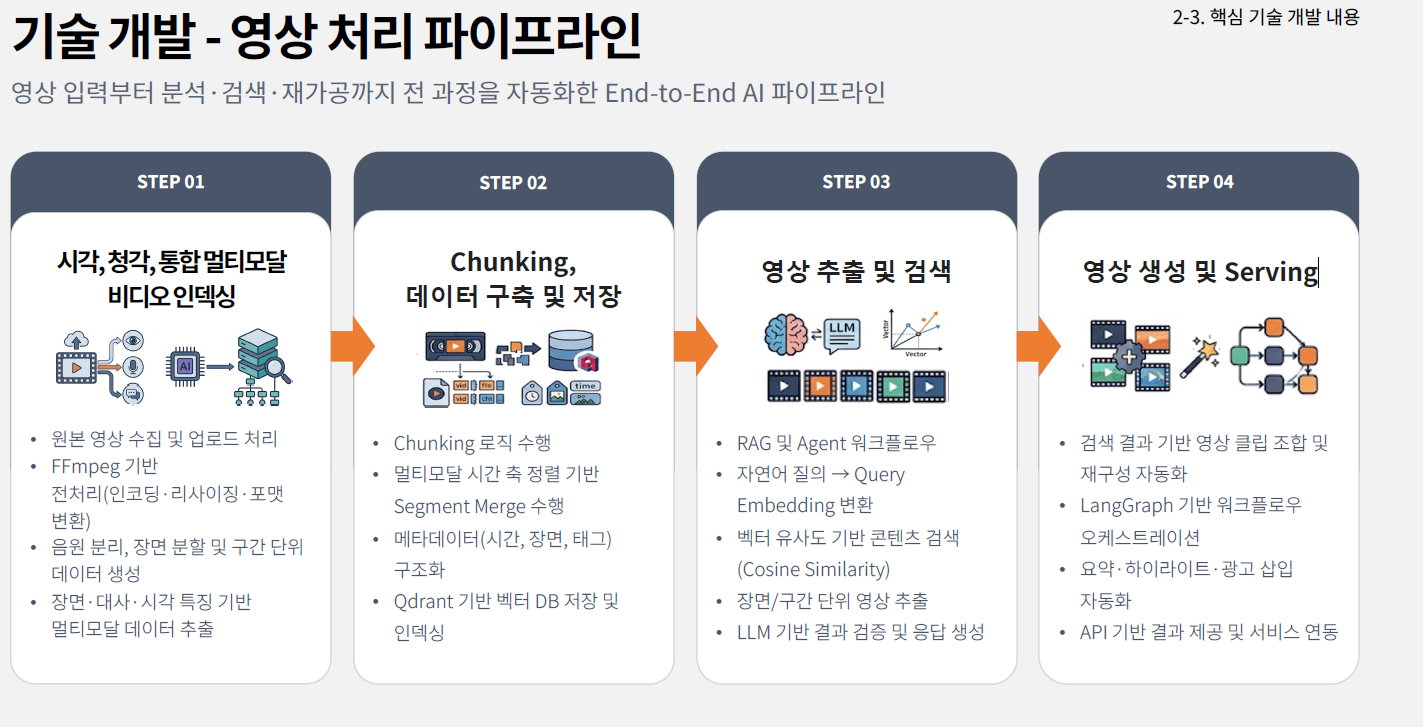
전체 파이프라인은 네 단계이며, 아래와 같다.
| STEP | 이름 | 한 줄 요약 |
|---|---|---|
| 01 | 멀티모달 비디오 인덱싱 | 영상을 AI가 읽을 수 있는 형태 로 분해한다 |
| 02 | Chunking · 저장 | 흩어진 정보를 의미 단위 장면 으로 묶어 저장한다 |
| 03 | 영상 추출 · 검색 | 자연어 질의로 원하는 장면을 찾아낸다 |
| 04 | 영상 생성 · Serving | 찾은 장면을 실제 결과물로 조립한다 |
조금 복잡한것 같아, step 별로 설명을 기재해본다.
STEP 01 — 시각·청각 통합 멀티모달 비디오 인덱싱
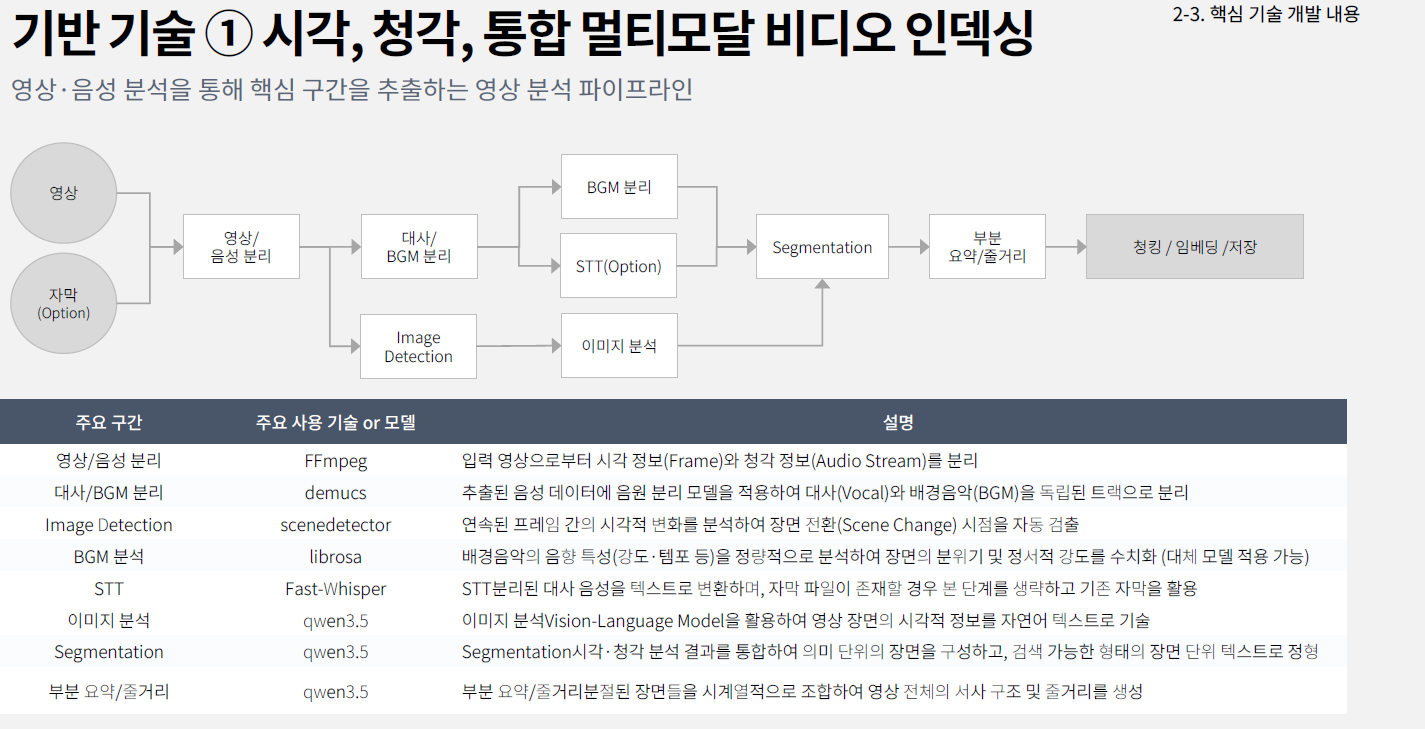
VLM에게 영상을 주는 게 아니라, VLM이 볼 만한 것만 골라서 주기로 했다.
그 뒤, 아래의 도구를 이용하여, 성능을 최적화 시키기로 했다.
| 구간 | 도구 | 하는 일 |
|---|---|---|
| 영상/음성 분리 | FFmpeg | 프레임과 오디오 스트림 분리 |
| 대사/BGM 분리 | demucs | 음성과 배경음악을 독립 트랙으로 분리 |
| 장면 전환 탐지 | PySceneDetect | 컷 전환 지점 자동 검출 → 분석 단위 확정 |
| STT | faster-whisper | 대사를 텍스트로. 단어별 타임스탬프 확보 |
| BGM 분석 | librosa | 음향 특성(강도·템포)으로 장면 분위기 수치화 |
| 이미지 분석 · 요약 | Qwen3.6 | 위 결과를 통합해 장면의 의미를 추론 |
여기서 배운 것 하나:
VLM은 눈이지, 파이프라인이 아니다. 전처리를 대충 하면 모델이 아무리 좋아도 안 된다. 도메인 적용의 절반은 모델 밖에서 일어난다.
STEP 02 — Chunking, 데이터 구축 및 저장
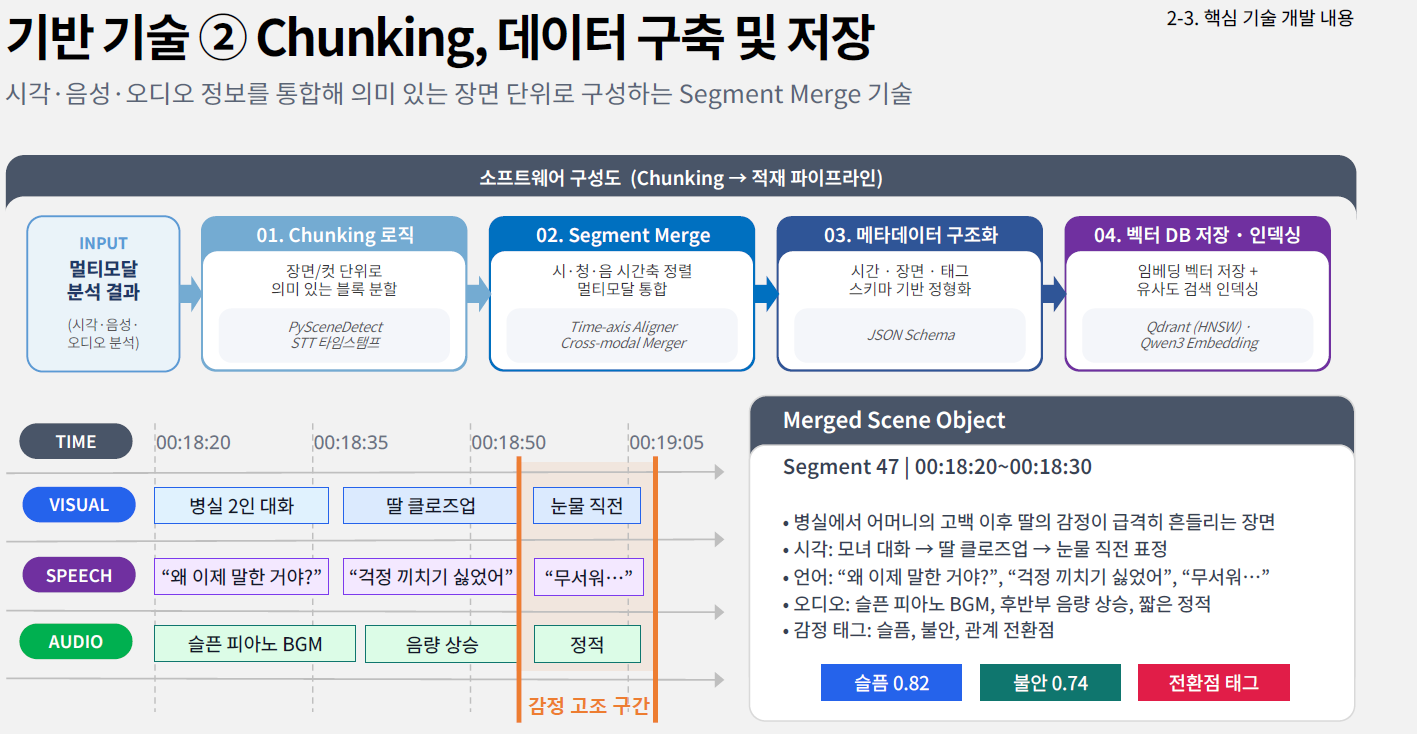
그래서 시각·음성·오디오를 같은 시간축에 정렬. 의미 단위로 다시 묶는다.
결과물은 이런 모양이다. (json 으로 할 예정)
Segment 47 | 00:18:20 ~ 00:18:30
─────────────────────────────────────────────
요약   병실에서 어머니의 고백 이후, 딸의 감정이 급격히 흔들리는 장면
시각   모녀 대화 → 딸 클로즈업 → 눈물 직전 표정
언어   "왜 이제 말한 거야?" / "걱정 끼치기 싫었어" / "무서워…"
오디오 슬픈 피아노 BGM, 후반부 음량 상승, 짧은 정적
감정   슬픔 0.82  불안 0.74  [관계 전환점]
이 객체를 임베딩해 Qdrant(벡터 DB) , 구조화 메타데이터는 MariaDB 에 저장한다.
의미 기반 검색과 조건 기반 필터링을 동시에 지원하는 하이브리드 구조다.
STEP 03 — 영상 추출 및 검색
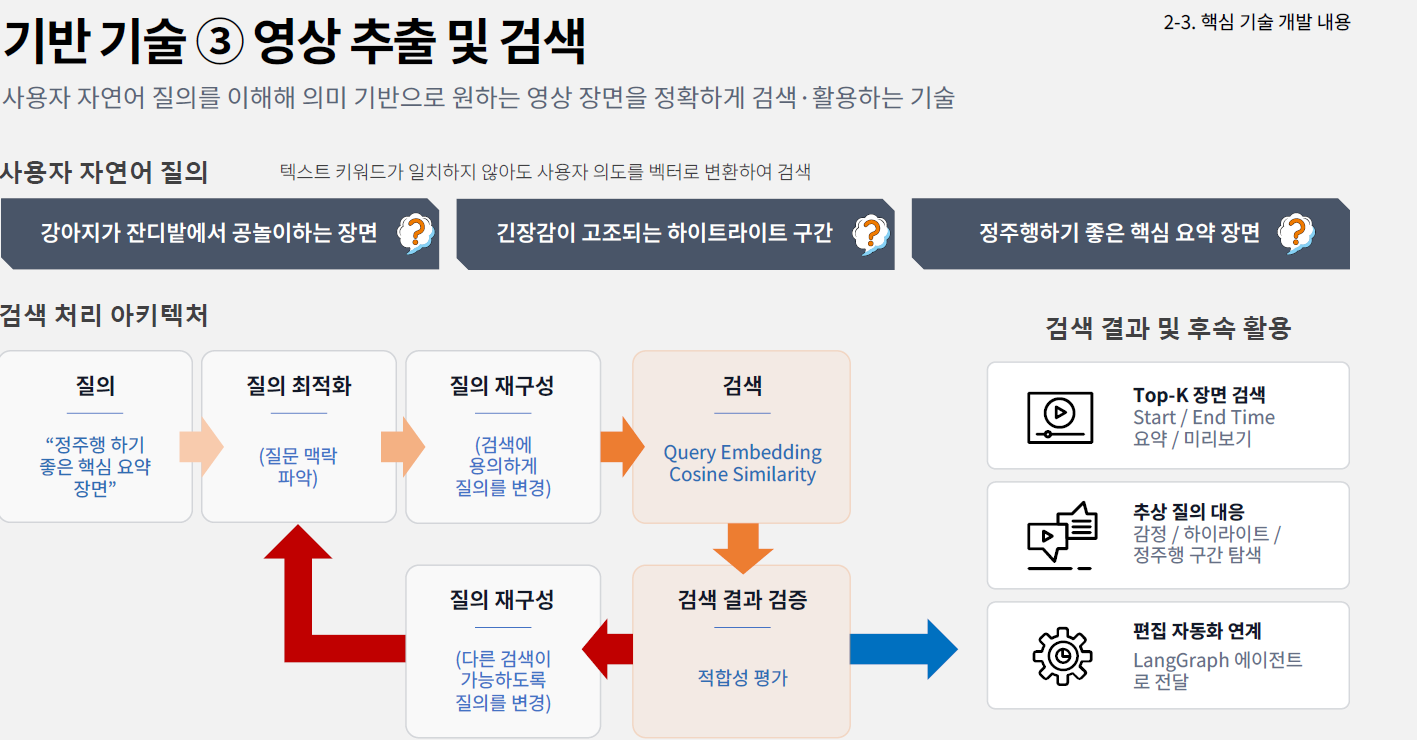
기존 메타데이터 검색은 키워드가 일치해야만 결과가 나온다.
서비스를 위해 질의 재구성 가능한 langraph 도입하기로 한 상태다..
단순 선형 파이프라인이 아니라 그래프 기반 순환 구조라서, 결과가 미흡하면 스스로 이전 단계로 돌아가 재시도한다고 한다
STEP 04 — 영상 생성 및 Serving
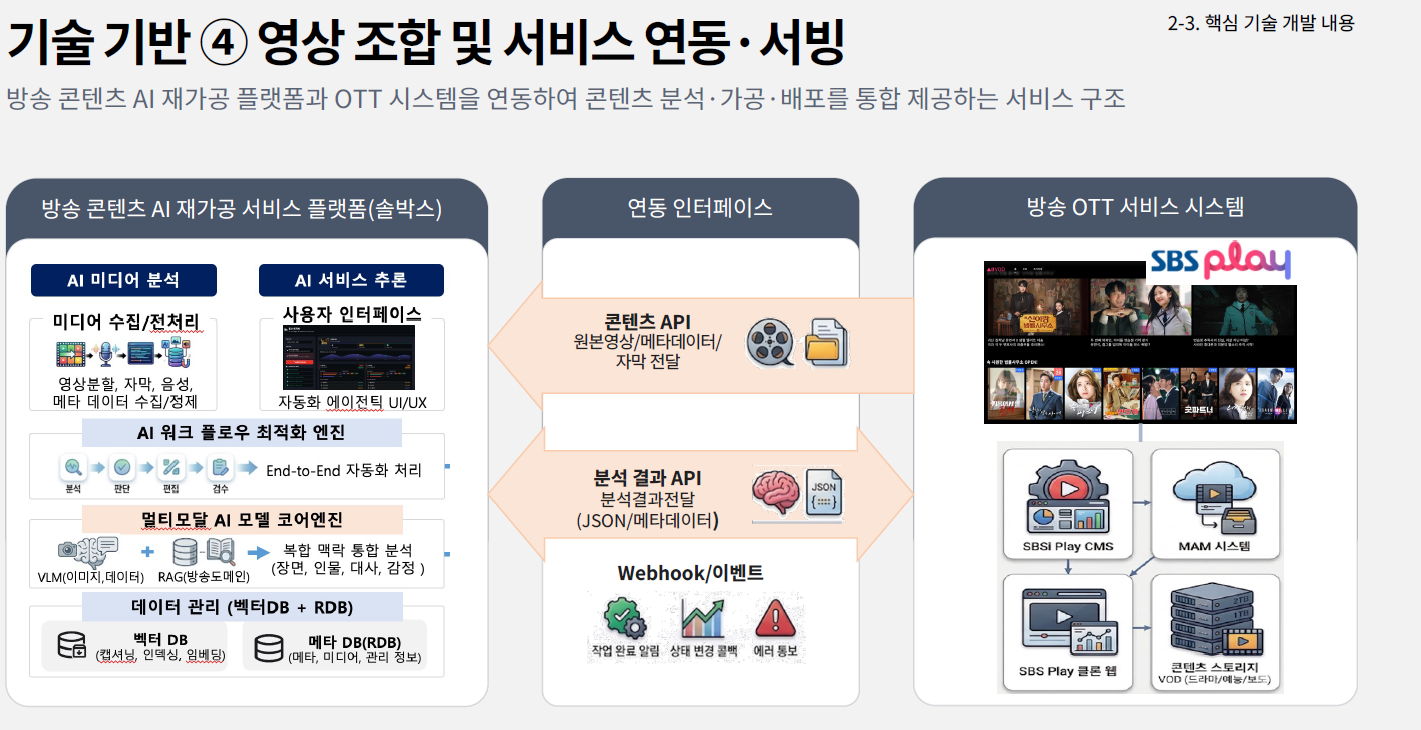
검색된 구간을 실제 영상으로 조립한다. 영상을 다시 인코딩하지 않고 필요한 구간만 잘라 내, 원본 품질을 유지하면서 플랫폼별 규격(16:9 / 9:16)으로 출력해보려 한다.
이 전 과정을 LangGraph 가 오케스트레이션하기로 했다.
3. 사용 오픈웨이트
현재 기준 아래 두 모델을 도입하여 시도 중에 있다.
| QWEN3.6-27B | https://huggingface.co/Qwen/Qwen3.6-27B |
|---|---|
| Qwen3.6-35B-A3B | https://huggingface.co/Qwen/Qwen3.6-35B-A3B |
4. 시스템 구축 및 서비스 흐름
💡 2026-07 / 프로젝트 시작 2개월 차, 구축된 시스템 및 서비스를 적어보았다.
시스템 구축
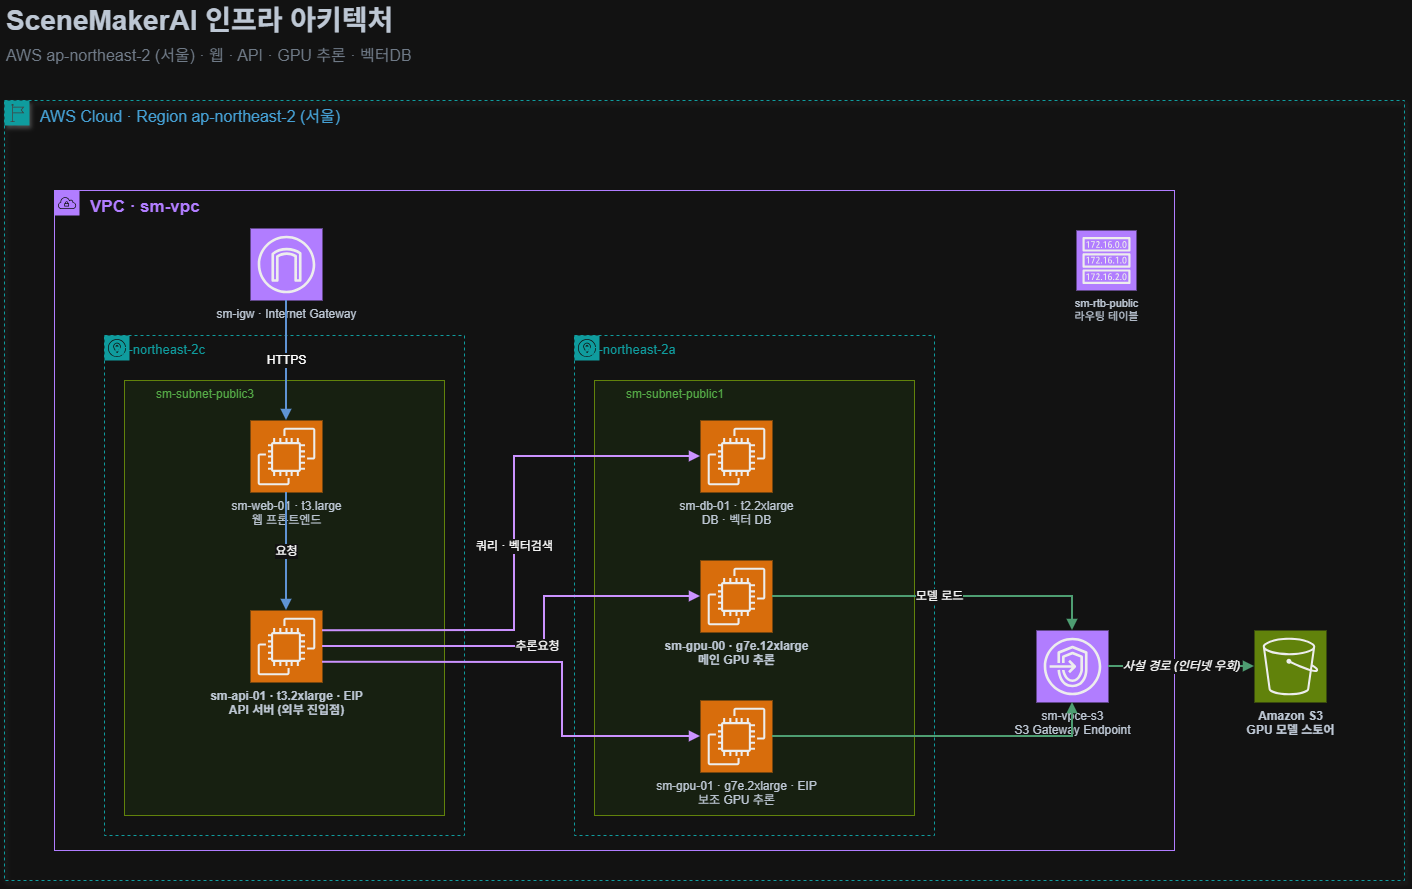
두 GPU 를 사용하기로 하였다.
| 인스턴스 이름 | 탑재 GPU 종류 | GPU 개수 | 총 GPU 메모리 (VRAM) | 메모리 특징 |
|---|---|---|---|---|
| g7e.2xlarge | NVIDIA RTX PRO 6000 Blackwell | 1개 | 96 GB | GDDR7, 대역폭 1,597 GB/s |
| g7e.12xlarge | NVIDIA RTX PRO 6000 Blackwell | 2개 | 192 GB (각 96 GB) | GDDR7, GPU 간 직접 통신(P2P) 지원 |
웹, API, DB 를 포함한 다이어그램을 그려보았다.
오늘 기준 다이어그램이며, 최종 배포 시에는 다를 수 있다.
서비스 흐름
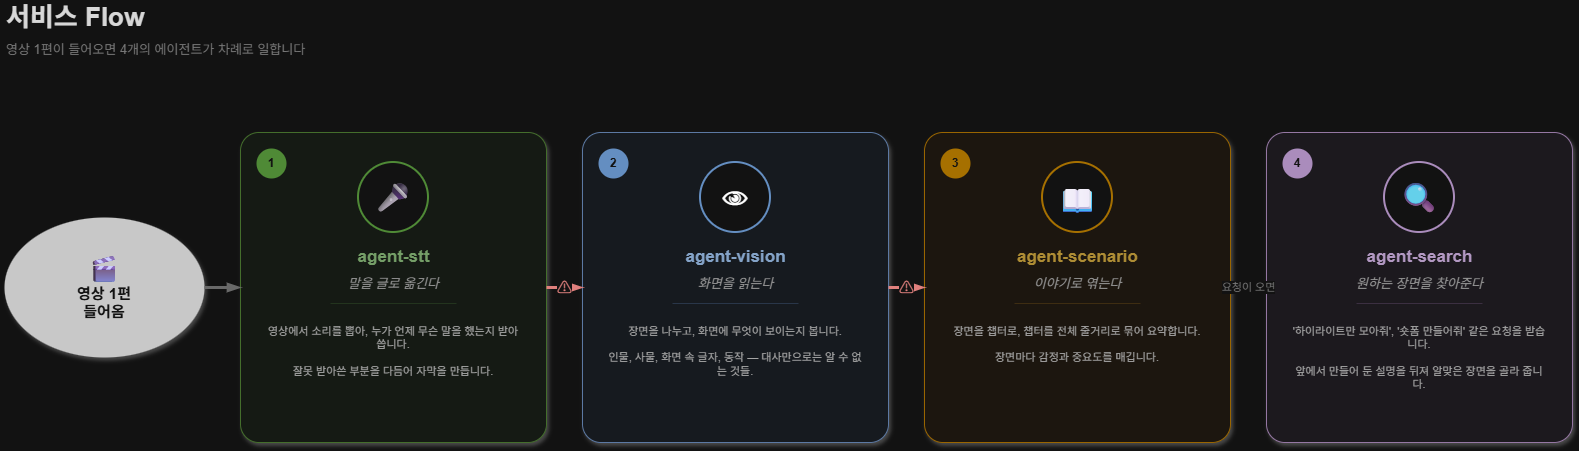
오늘까지 구축한 agent 아래의 4개이다.
| 에이전트 | 역할 | 주요 스택 |
|---|---|---|
| agent-stt | 음성 인식, 화자별 대사 추출, 자막 생성 | faster-whisper, demucs |
| agent-vision | 장면 탐지, 프레임 분석, 시각 맥락 추론 | PySceneDetect, Qwen3.6 VLM |
| agent-scenario | 서사 구조 파악, 감정 흐름 분석, 장면 병합 | Qwen3.6, RAG |
| agent-search | 자연어 질의 → 장면 검색, 구간 추출 | Qdrant, Embedding |
4개의 독립 에이전트 로 분리했다. (또한 STT 의 경우, 2차 보정 까지 시키는 상태다)
오늘 기준의 서비스 flow 를 그림으로 정리했다.
5. 다음 글 예고
이번 글에서는 무엇을 만들 예정인지, 어떻게 구축 예정인지 방식을 다뤘다.
다음 글부터는 실제로 하나하나 과정을 선보일 예정이다.
- 음성분석 처리 과정 및 결과
- faster-whisper 한국어 음성인식 최적화 경험 공유
참고
- Qwen3.6-27B: https://huggingface.co/Qwen/Qwen3.6-27B
- Qwen3.6-35B-A3B: https://huggingface.co/Qwen/Qwen3.6-35B-A3B
- vLLM: https://github.com/vllm-project/vllm
- LangGraph: https://github.com/langchain-ai/langgraph
- faster-whisper: https://github.com/SYSTRAN/faster-whisper
- PySceneDetect: https://github.com/Breakthrough/PySceneDetect
- demucs: https://github.com/adefossez/demucs
- Qdrant: https://github.com/qdrant/qdrant
- Amazon EC2 G7e: https://aws.amazon.com/ec2/instance-types/g7e/
본 글은 과학기술정보통신부·정보통신산업진흥원 「2026년 오픈소스 AI·SW 개발·활용 지원사업」의 지원으로 수행된 연구 결과입니다.