RAG 파이프라인 구축

들어가며
기본 RAG 를 간단히 표현하면 아래 세 단계다.
- 문서 구조화 파싱 (Parsing)
- 의미 단위 분할 청킹(Chunking) / 벡터화 임베딩 (Embedding)
- 사실 기반 완성 검색 (Retrieval) / 답변 (Generating)
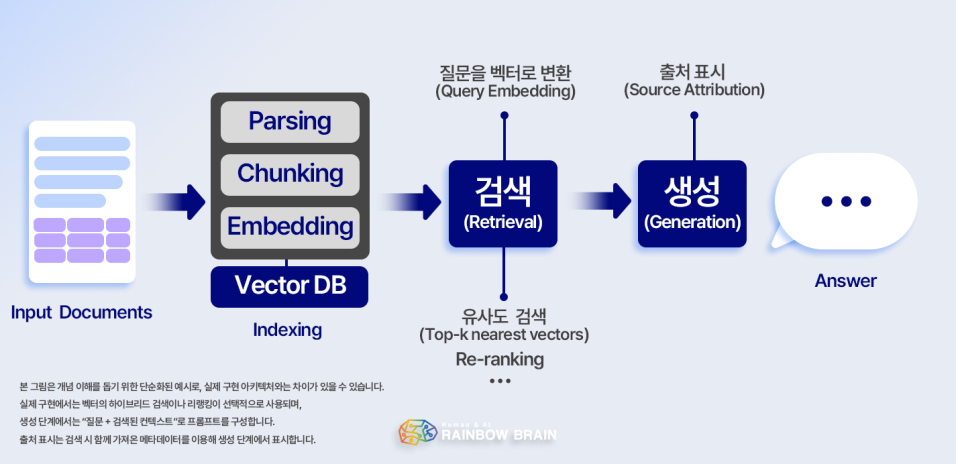
문서 RAG 라면 3단계에서 문단을 인용하면 끝이다.
우리 쪽은 방송 영상이라, 답이 문단이 아니라 클립 구간(v_id + start~end) 이다.
그래서 Parsing·Chunking·Retrieval 을 각각의 에이전트 단위로 나누었다 .
RAG 파이프라인 = agent-scenario(색인) + agent-search(검색·생성)
Scenemaker Agent 구축
💡 전체 Scenemaker Multi Agent 는 아래와 같이 구성하였다.
1. 파싱 (Parsing) — 영상을 분석 데이터로 사용
-
자막 — agent-stt
- STT → 대사
- (Whisper, 차기 Qwen3-ASR) 모델 설정 중
- STT → 대사
-
화면 — agent-vision
-
VLM → 화면·OCR·동작
-
오디오 → 소리·BGM
-
2.청킹·임베딩 (Chunking + Embedding) — agent-scenario
- 세그먼트를 의미 계층 으로 접음. 벡터로 색인한다.
-
4계층 분할: 세그먼트 → 씬 → 서브 → 전체 줄거리 (map-reduce)
-
임베딩 후 Milvus 1개 컬렉션 에 색인
-
3. 검색·생성 (Retrieval + Generation) — agent-search
- 질의를 받아 LangGraph 6단계 로 클립 구간을 찾는다.
- 결과물은 클립 구간 목록 (v_id + start~end)
테이블 구현
| 공정 | 담당 | 하는 일 |
|---|---|---|
| 업로드 | ui-workspace (Next.js) | S3 업로드 + 분석결과 조회 콘솔 |
| ① 자막 | agent-stt | 음성 → 대사·화자, vLLM 자막교정 |
| ② 화면분석 | agent-vision | 6초 세그먼트 화면·OCR·소리·동작 분석 |
| ③ 색인 | agent-scenario | 씬→막→전체 map-reduce 요약 + 인물 신원 해소 + 임베딩 |
| ④ 검색 | agent-search | LangGraph 6단계(scope→plan→retrieve→expand→select→assemble)로 질의 → 클립 |
agent-scenario / agent-search 가 어떤 Flow 인지만 먼저 보고,
세부 구현·튜닝은 이어지는 글에서 다룬다.
Agent-Scenario
💡 영상 분석 결과를 줄거리·인물·벡터로 저장하는 색인 쪽 Flow
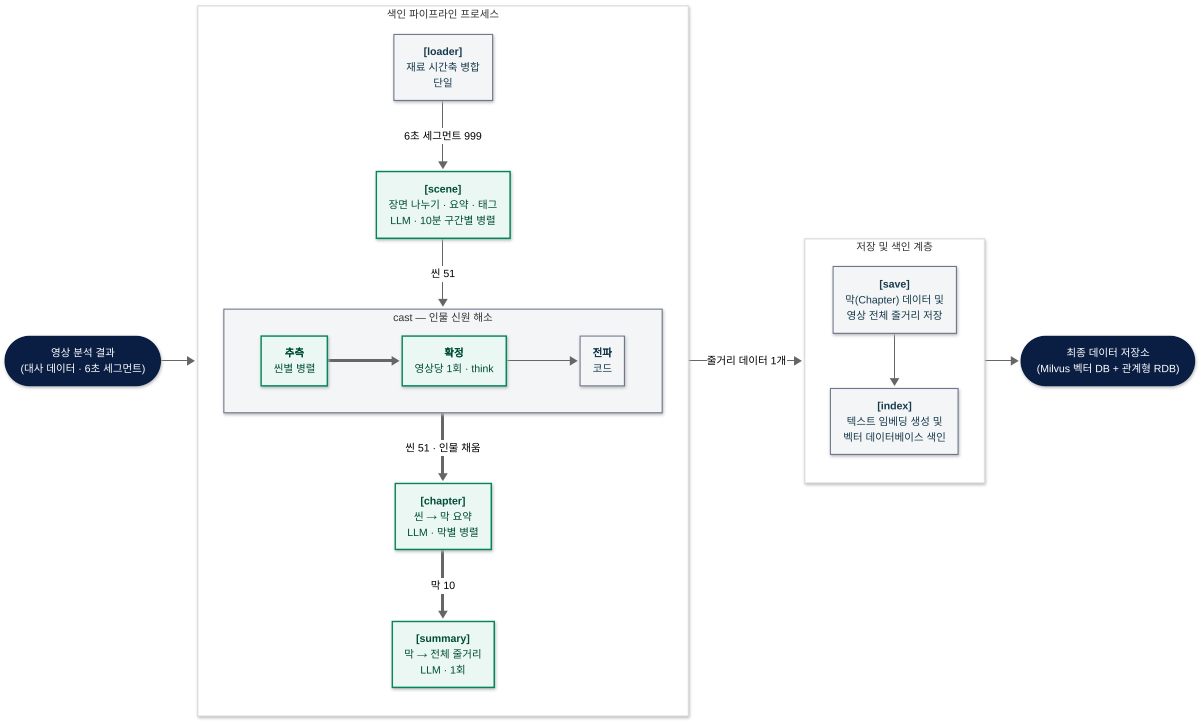
Agent-Scenario 정리 테이블
| # | 단계 | 쉽게 말하면 | 실제로 하는 일 | Qwen3.6 |
|---|---|---|---|---|
| 0 | loader | 재료 펼치기 | 영상 내 대사(t_dialogue) 화면(t_segment) 시간순 병합 | ❌ |
| 1 | scene | 장면 나누기 | 씬 경계 + 요약 + 태그 (하이라이트·감정·광고) | ✅ 10분 구간마다 |
| 2 | cast | 누가 누군지 밝히기 | 추측 → 확정 → 전파 (확정만 think 켬) | ✅ 씬마다 + 1회 |
| 3 | chapter | 막으로 묶기 | 씬들을 10분 "막"으로 묶어 요약 (reduce) | ✅ 막마다 |
| 4 | summary | 전체 줄거리 쓰기 | 막들을 묶어 영상 한 편 줄거리로 (reduce) | ✅ 1회 |
| 5 | save | 노트 저장 | DB 기록 | ❌ |
| 6 | index | 검색되게 색인 | 임베딩 → Milvus 1개 컬렉션 | ❌ |
한 줄로 보면, 6초 원자 → 의미 단위로 접기 → 벡터로 넣기 다.
긴 영상을 한 번에 요약하지 않고 map-reduce 로 접는 이유, 그리고 매 단계에 타임코드를 남기는 이유가 같다 — 최종 목적이 클립 제작 이라서다.
cast 의 “추측 → 확정 → 전파” 도 같은 맥락이다. 장면 하나만으로는 누군지 모르니, 영상 전체에서 한 번 확정한 뒤 각 씬에 다시 채운다.
Agent-Search
💡 영상 검색 과정을 나타내는 그래프
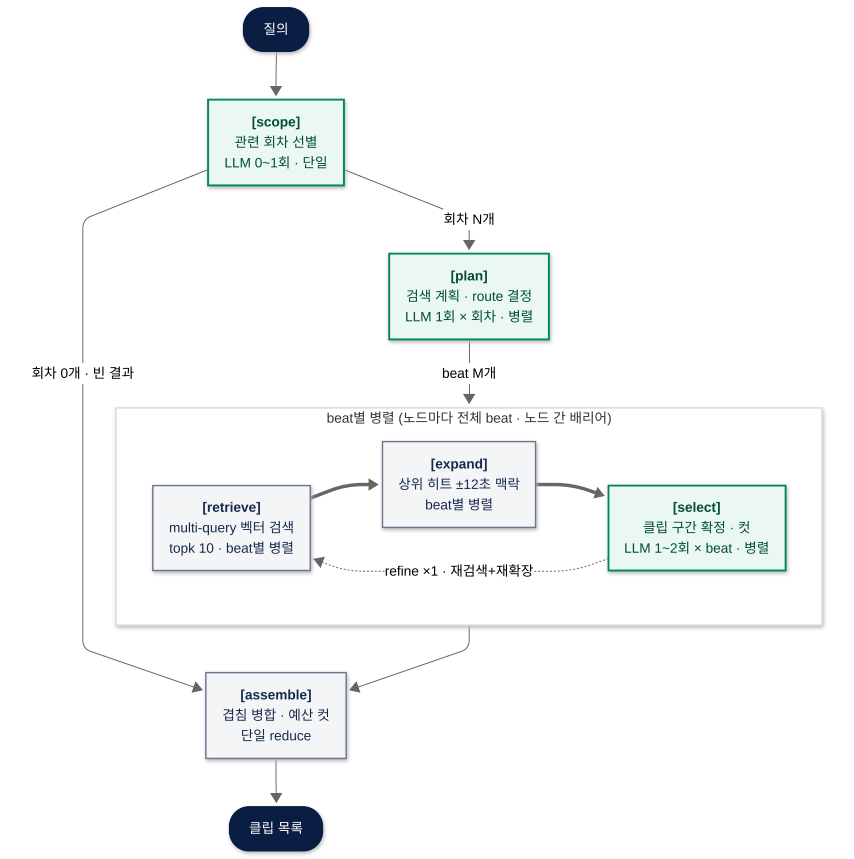
Agent-search 노드별 정리 테이블
| # | 노드 | 쉽게 말하면 | 실제로 하는 일 | Qwen3.6 |
|---|---|---|---|---|
| 1 | scope | 어느 영상이지? | 관련 회차만 골라냄 (챕터 벡터 40표 투표 → LLM 확정, 최대 5개) | ✅ 0~1회 |
| 2 | plan | 뭘 찾을지 목록 짜기 | 찾을 장면(beat) 리스트 + 장면마다 검색어 2~3개 + route 결정 | ✅ 회차당 1회 |
| 3 | retrieve | 비슷한 조각 긁어오기 | 검색어로 벡터 검색 → 중복 제거 → 상위 10개 후보 | ❌ |
| 4 | expand | 앞뒤도 같이 보기 | 상위 히트 앞뒤 ±12초 맥락 창 붙이기 | ❌ |
| 5 | select | 진짜 맞아? 어디~어디 자르지? | 클립 구간[start~end] 확정 아니면 버림 (재질의 1회) | ✅ beat당 1~2회 |
| 6 | assemble | 합치고,길이 맞추기 | 겹침 병합 → 목표 길이만큼 추림 → 정렬 → 최종 목록 | ❌ |
문서 RAG 와 가장 다른 지점은 retrieve 다음 이다.
6초 히트는 클립이 아니라서, expand 로 앞뒤를 붙인 뒤 select 가 자를 구간을 정한다.
못 맞히면 억지로 채우지 않고 버린다(재질의는 beat당 1회).
LLM 은 scope / plan / select 에만 쓰고, retrieve·expand·assemble 은 코드다.
노드를 어떻게 조립했는지(입출력 등)는 추후 글에서 이어간다.
마무리
현재 파이프라인 구축까지만 마친 상태이며, 실제 모델 학습, 코드 구현 등은 진행 중에 있다.
추후 다음 글에서는 해당 파이프라인 기반으로, 방송 워크플로우 설계를 기재한다.
본 글은 과학기술정보통신부·정보통신산업진흥원 「2026년 오픈소스 AI·SW 개발·활용 지원사업」의 지원으로 수행된 연구 결과입니다.