숏폼 자동 생성 파이프라인 해설_1

들어가며
드라마 한 편을 넣으면 숏폼으로 잘라 쓸 수 있는 재료가 나오기까지의 과정을 구체적으로 명시한 글이다.
숏폼을 자동으로 만들려면, 먼저 영상이 언제 / 어디서 / 누가 / 무슨 말을 했는지 로 쪼개져 있어야 한다.
이 글은 그 재료를 만드는 1차 버전(2026-09-16 ~ 09-29) 파이프라인을 다룬다.
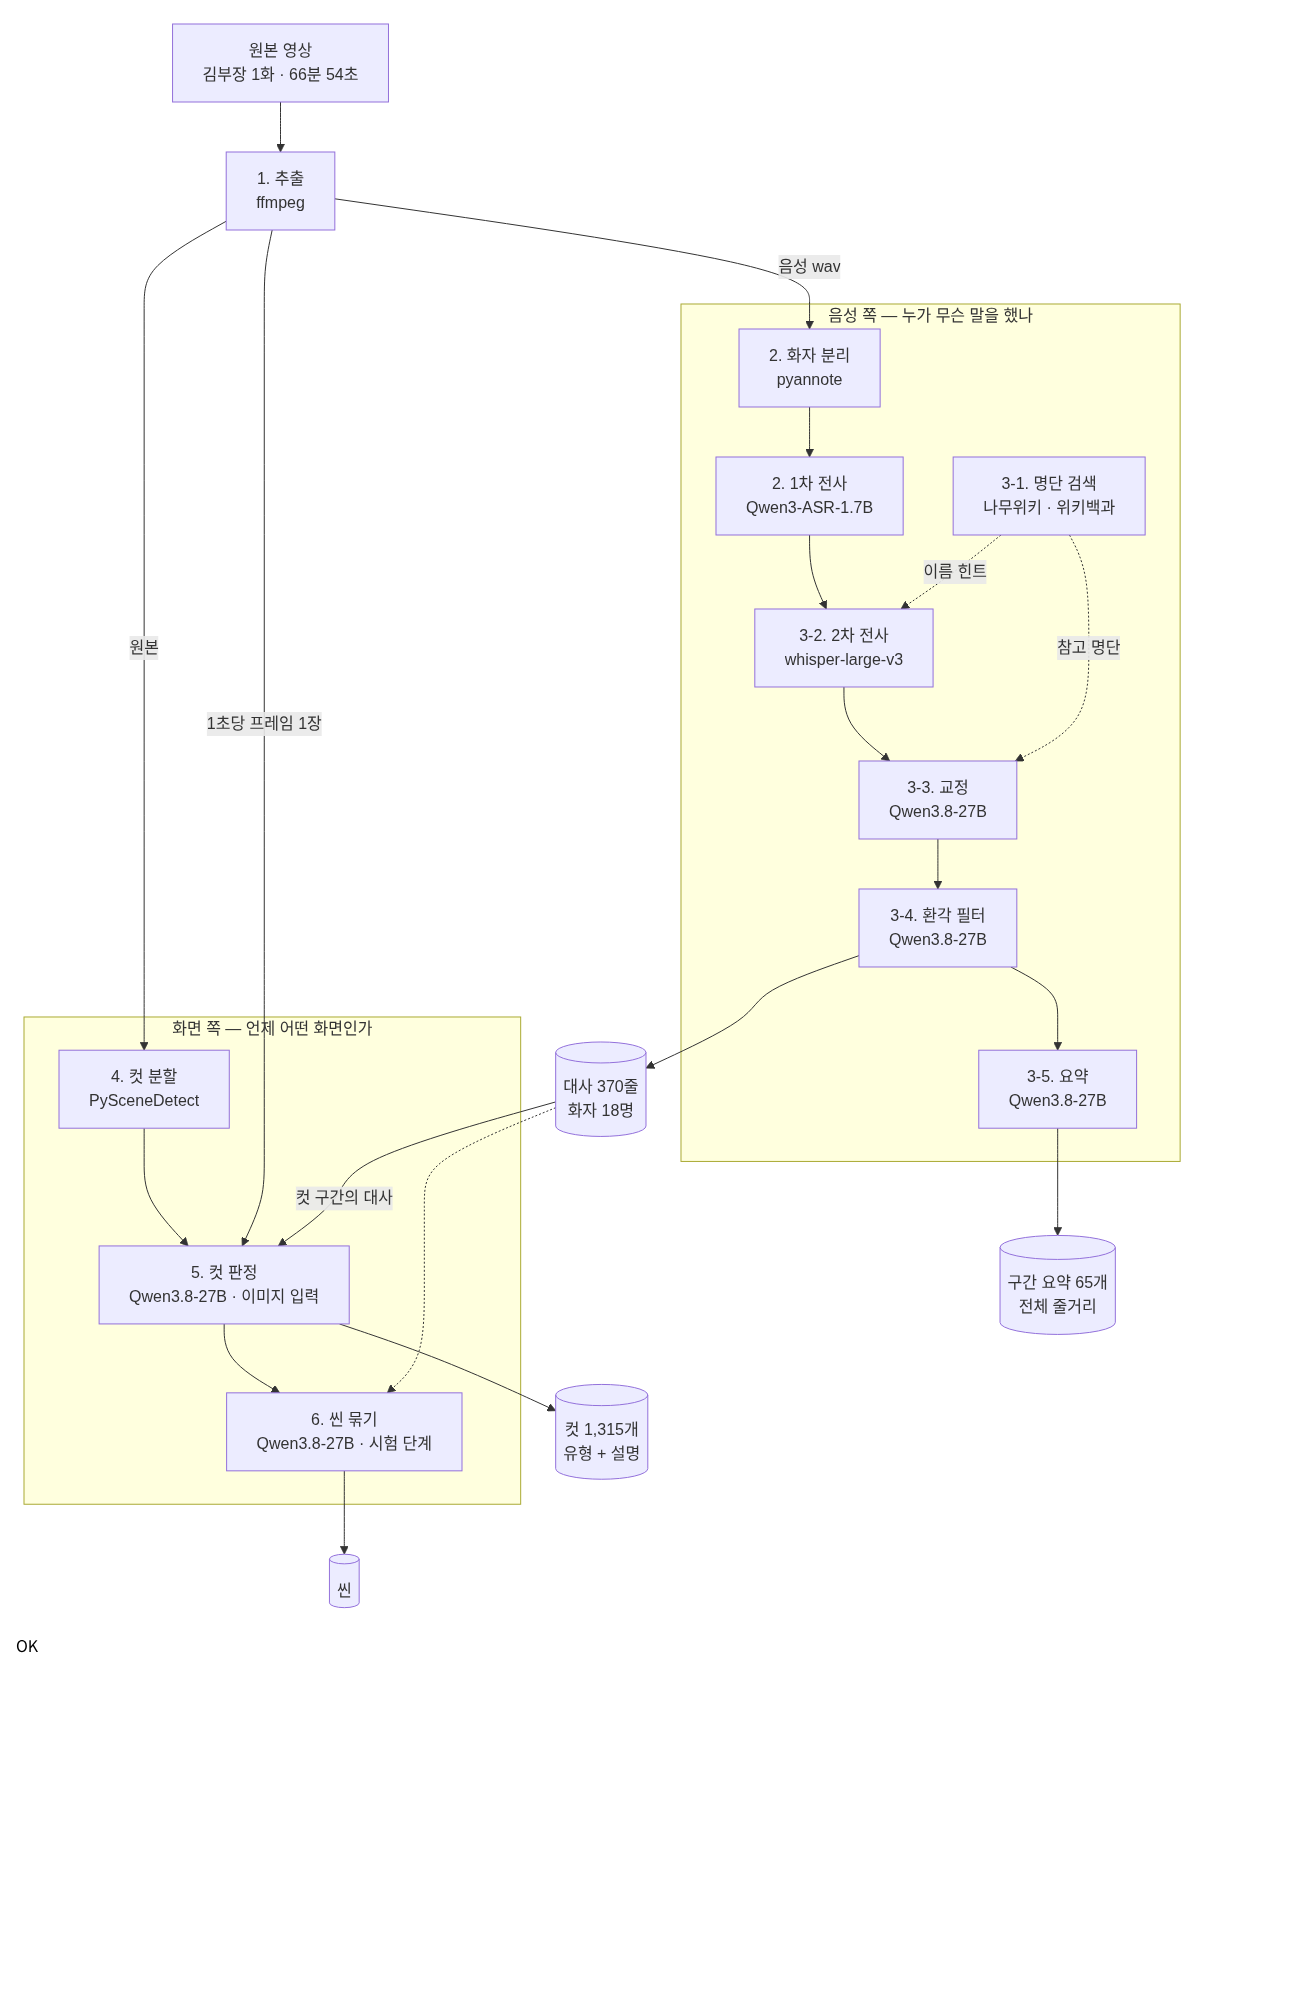
파이프라인을 가장 쉽게 요약하면 아래와 같다.
- 음성·프레임 추출 (ffmpeg)
- 음성 → 대사 (STT)
- 대사 다듬기 (교정 · 환각 필터 · 요약)
- 화면이 바뀌는 지점 찾기 (컷 분할)
- 컷마다 화면 분류 (컷 판정)
- 컷을 씬으로 묶기 (씬 묶기)
서비스가 여러 개로 나뉘어 있고, 최종 Flow 는 아래와 같이 하였다.
# 드라마 1편 처리 순서

POST /api/v1/pre_svc                     # agent-stt
 ├ 1) prep.process          원본 내려받기 + 음성·프레임 추출   (worker-prep_stt)
 ├ 2) stt.run               화자 분리 + 1차 전사               (worker-prep_stt)
 ├ 3) pipe_audio.run        검색 → 2차 전사 → 교정 → 필터 → 요약 (agent-stt)
 │
POST /api/v1/analyze                     # agent-vision
 ├ 4) detect_windows        컷 분할                            (worker-prep-vision)
 ├ 5) vision.run            컷 판정  ◀── 화면을 보는 건 여기 하나
 └ 6) 씬 묶기               컷 → 씬 (이 시기엔 시험 단계)
단계별로 사용한 모델이다.
| 단계 | 모델 | 입력 |
|---|---|---|
| 1) 추출 | 없음 (ffmpeg) | 영상 |
| 2) 화자 분리 | pyannote-diarization | 음성 |
| 2) 1차 전사 | Qwen3-ASR-1.7B + Qwen3-ForcedAligner-0.6B | 음성 |
| 3) 2차 전사 | whisper-large-v3 (faster-whisper) | 음성 |
| 3) 검색·교정·필터·요약 | Qwen3.8-27B-FP8 | 글자 |
| 4) 컷 분할 | 없음 (PySceneDetect) | 영상 |
| 5) 컷 판정 | Qwen3.8-27B-FP8 | 이미지 + 글자 |
| 6) 씬 묶기 | Qwen3.8-27B-FP8 | 글자 |
언어 모델은 Qwen3.8-27B-FP8 하나다. GPU 3장에 한 벌씩 올려 vLLM 으로 띄웠다.
vllm serve /mnt/nvme/models/Qwen3.8-27B-FP8 \
    --served-model-name qwen \
    --max-model-len 131072 \
    --max-num-seqs 24 \
    --allowed-local-media-path /mnt/nvme/vod \
    --limit-mm-per-prompt '{"image":30}' \
    --enable-prefix-caching
-max-num-seqs 24: GPU 한 장당 동시 24건까지 받는다.-allowed-local-media-path: 프레임 이미지를 파일 경로로 받기 위한 설정이다. (5번 단계에서 쓴다)
1. 음성·프레임 추출 (ffmpeg)
- 원본에서 음성 파일 1개 와 1초당 프레임 1장 을 뽑는다. 뒤 단계는 원본을 다시 열지 않는다.
FPS = 1                 # 초당 1장
FRAME_SIZE = "1280:720"
JPEG_Q = 2              # 낮을수록 고화질

## worker-prep_stt/lib/svc/prep/ffmpeg.py

def extract_media(video_path: Path, audio_path: Path) -> int:
    ...
    cmd = (
        f"{config.FFMPEG_DIR / 'ffmpeg'} -y "
        f"-hwaccel cuda -hwaccel_output_format cuda -hwaccel_device {HWACCEL_DEVICE} -i {video_path} "
        # 출력1: 오디오 (16k mono)
        f"-map 0:a -vn -ac 1 -ar 16000 -c:a pcm_s16le {audio_path} "
        # 출력2: 1fps 프레임 (GPU 디코드 → GPU 스케일 → JPEG)
        f'-map 0:v -vf "fps={FPS},scale_cuda={FRAME_SIZE},hwdownload,format=nv12" '
        f"-q:v {JPEG_Q} -start_number 0 {job_dir}/%05d.jpg"
    )
    proc = subprocess.run(cmd, shell=True, capture_output=True, text=True, timeout=FFMPEG_TIMEOUT)

    # 마지막 프레임 번호 = end_idx
    idxs = [int(p.stem) for p in job_dir.glob("*.jpg") if p.stem.isdigit()]
    return max(idxs) if idxs else -1
-
원본을 1회만 디코드 해서 음성과 프레임을 동시에 만든다.
- 음성 따로, 프레임 따로 2번 읽지 않는다.
-
프레임 파일 이름이 곧 초다.
00123.jpg= 123초 화면. 뒤 단계가 "몇 초 화면" 을 경로로 바로 찾는다.
-
원본이 그대로이고 산출물이 이미 있으면 건너뛴다.
-
예시 입출력
입력:  VOD.mp4                              ← 67분짜리 원본
출력:  VOD_audio.wav                        ← 16kHz mono
       00000.jpg, 00001.jpg, ... 04014.jpg  ← 1초당 1장 (1280x720)
2. 화자 분리 + 1차 전사 (pyannote, Qwen3-ASR)
- 사람이 말한 구간과 화자를 먼저 찾고, 그 구간만 받아쓴다.
## worker-prep_stt/lib/svc/stt/stt.py

def run(audio_path: str, vid: str, category: str = "") -> list[dict]:
    audio = _load_audio(audio_path)

    # 1) 화자 턴 (ASR 이 turns 로 창을 병합하므로 선행)
    turns = run_diarize(audio)

    # 2) 창 병합 + 창별 ASR + 정렬
    win_results = run_asr(audio, turns, category=category)

    # 3) 조립: 창별 (text + items + 화자) → segments
    segs = assemble.assemble_windows(win_results, turns)
    ...
-
음성을 통째로 넣지 않는다.
-
음악·침묵이 섞이면 타임스탬프가 흩어지고, 무음에서 같은 말을 반복한다.
-
말 구간만 잘라 넣으면 둘 다 사라진다.
-
-
반대로 너무 짧게 넣어도 안 된다.
-
0.3초짜리 "네" 하나만 주면 언어를 러시아어·일본어로 잘못 짚는다.
-
그래서 화자 턴을 약 30초 창 으로 병합한다.
-
TARGET_SEC = 30.0   # 목표 길이 (자르는 선이 아니다)
GAP_SPLIT = 3.0     # 이보다 긴 침묵은 창을 끊는다

## worker-prep_stt/lib/svc/stt/window.py

def make_windows(turns: list[dict], audio_sec: float) -> list[tuple[float, float]]:
    ts = sorted(turns, key=lambda t: t["start"])
    windows = []
    ws, we = ts[0]["start"], ts[0]["end"]

    for t in ts[1:]:
        gap = t["start"] - we
        if gap > GAP_SPLIT or (t["end"] - ws) > TARGET_SEC:
            windows.append((ws, we))          # 현재 창 닫음 (턴 끝 = 침묵)
            ws, we = t["start"], t["end"]
        else:
            we = max(we, t["end"])            # 겹침/작은 갭 → 병합
    windows.append((ws, we))
    return [(round(s, 3), round(min(e, audio_sec), 3)) for s, e in windows]
-
결론
-
창을 닫는 곳은 항상 턴의 끝(침묵)이다. 말 중간을 자르지 않는다.
-
3초 넘는 침묵·음악은 창에 넣지 않는다.
-
-
예시 입출력
입력:  [침묵··말(S1)·말(S2)··음악·····말(S1)···]   ← 음성 전체
출력:  [
    {"idx": 0, "start": "00:10:24.0", "end": "00:10:35.0", "text": "...", "lang": "Korean", "speaker": "S005"},
    {"idx": 1, "start": "00:10:36.0", "end": "00:10:45.0", "text": "...", "lang": "Korean", "speaker": "S005"},
    ...
]
3. 대사 다듬기 (Qwen3.8-27B, whisper-large-v3)
- 1차 전사는 사람 이름과 발음이 비슷한 단어를 자주 틀린다.
- 이번엔 받아쓴 글자를 고치는 부분 이다. 스텝 6개가 순서대로 돈다.
## agent-stt/lib/svc/audio/pipe_audio.py

#   (검색) → stt → (whisper) → 교정 → 할루시 → (요약)
#
# 순서는 데이터 의존이라 바꿀 수 없다:
#   검색 → whisper : 명단에서 뽑은 이름이 whisper initial_prompt 로 들어간다(이름 정확도↑)
#   whisper → 교정 : 2차 전사가 교정의 [B] 대조본이 된다
#   할루시 → 요약  : 요약은 걸러낸 대사(kept)만 본다
카테고리에 따라 스텝을 켜고 끈다. 드라마는 전부 켠다.
## agent-stt/lib/svc/profile.py

TABLE: dict[str, Profile] = {
    "드라마": Profile(audio=Audio(search=True, stt_qwen=True, stt_whisper=True, correct=True,
                               correct_glossary=True, hallu=True, summary=True)),
    "다큐":   Profile(audio=Audio(search=False, stt_qwen=True, stt_whisper=False, correct=True,
                               correct_glossary=False, hallu=True, summary=True)),
    ...
}
3-1. 명단 검색
- 제목과 연도로 등장인물 명단을 웹에서 찾는다.
N_QUERIES = 4
SITES = ["namu.wiki", "ko.wikipedia.org", "en.wikipedia.org"]

# ② 질의 생성 : LLM 이 "site:<도메인> <검색어>" 질의 4개를 만든다
# ③ 검색+본문 : 질의별로 문서 1개 확보 (200자 미만이면 다음 후보)
# ④ 내용 취합 : LLM 이 본문들에서 명단만 텍스트로 추린다
- 검색은 20초, 1차 전사는 수 분이 걸린다.
-
검색을 먼저 띄워두고 전사 뒤에 숨긴다. (대기 0)
-
실패하면 명단 없이 진행한다.
-
3-2. 2차 전사 (whisper)
- 1차를 대체하는 게 아니다. 교정 때 대조할 두 번째 의견 만 모은다.
MIN_SEC = 3.0      # 3초 미만 구간은 보내지 않는다
MIN_CHARS = 12     # 12자 미만도 보내지 않는다
MIN_KO = 0.5       # 한글 비율 50% 미만도 보내지 않는다
- 짧은 추임새나 외국어 구간을 보내면 whisper 가 없는 말을 지어낸다.
- 검색한 명단의 이름을
initial_prompt로 넘긴다.- 이름이 맞으면 주변 단어도 같이 안정된다.
3-3. 교정
- 대사를 30줄씩 나눠 LLM 에 병렬로 보낸다.
PAGE_MAX_SEGMENTS = 30   # 페이지당(=LLM 호출당) 최대 자막 줄 수

## agent-stt/lib/svc/audio/correct/vllm_correct.py

SYSTEM = """너는 한국어 자막(STT 결과) 교정기다. 입력은 음성인식으로 생성돼 오탈자·오인식이 섞여 있다.
각 줄은 'idx: 원문' 이고, 일부 줄 아래에는 같은 오디오를 다른 시스템이 받아쓴 [B] 가 붙는다.

[교정 절차 — 반드시 이 순서로]
1) 초안 결합 — 원문은 **내용의 범위**를, [B] 는 **표현의 정확도**를 담당한다.
2) 이름·자리 확인 — 사람 이름은 [참고 명단] 표기를 따른다.
3) 용어집 적용
4) 표기 정리

[지킬 것]
- 입력 줄 수와 순서를 그대로 유지. 줄을 합치거나 나누지 않는다.
...
"""
- 페이지가 실패하면(응답 깨짐, 줄 번호 불일치) 원문을 그대로 둔다.
- 자막은 한 줄도 빠지면 안 된다. 교정 실패 < 원문 보존.
3-4. 환각 필터
- 주 언어와 다른 줄만 골라 LLM 이 앞뒤 문맥과 함께 판정한다.
keep   — 진짜 외국어 발화 (인터뷰·가사·광고)
drop   — 잡음성 할루시 (무의미 음절 등)       → 삭제
relang — LID 오분류 (실제론 주언어)           → 지우지 않고 lang 만 교정
3-5. 요약
SUMMARY_WINDOW_SEC = 60   # 1분 창마다 요약
SUMMARY_CHUNKS = 8        # 8덩이로 나눠 동시 실행. 덩이 안은 순차(문맥 유지)
-
여러 구간을 한 프롬프트에 묶으면 빨라지지만 구간끼리 내용이 섞였다.
- 호출 하나는 그대로 두고, 줄기만 8개로 늘렸다.
-
결과 확인
# 대사 (t_dialogue) — 67분 회차에서 370줄, 화자 18명
seq  start  end  speaker  dialogue
41   624    635  S005     뭐 이거 법인 카드 내역인데요. 지난주 수요일 9만 5천 원이 중식비로 ...
42   636    645  S005     영수증도 누락되어 있고 뭔가 착오가 있는 게 아니신지. ...
45   655    659  S007     융통성 그냥 회식비로 처리해, 응?

# 구간 요약 (t_dialogue_summary) — 1분 창 65개
seq  start     end       summary
10   00:11:00  00:12:00  부지점장은 지적을 받아들이며 해당 비용을 회식비로 처리하겠다고 답한다. ...
여기부터는 화면을 다룬다.
화면 분석은 agent-vision 이 맡고, 무거운 영상 처리는 워커(worker-prep-vision )에 넘긴다.
4. 컷 분할 (PySceneDetect)
- 화면이 바뀌는 지점을 찾는다. 모델은 쓰지 않는다.
prep_threshold: float = 15.0   # 인접 프레임 HSV 변화 점수 임계 — 낮을수록 컷 촘촘
prep_min_sec: float = 1.0      # 세그 최소 길이 — 미만이면 이웃과 병합
prep_max_sec: float = 15.0     # 세그 최대 길이 — 초과하면 균등분할

## worker-prep-vision/src/service/prep/detect.py

def detect_scenes(path: Path, threshold: float, min_sec: float) -> tuple[list, float]:
    from scenedetect import SceneManager, open_video
    from scenedetect.detectors import ContentDetector

    video = open_video(str(path))
    total = video.duration.get_seconds()
    min_scene_len = max(1, round(min_sec * video.frame_rate))  # 초 → 프레임 수 환산

    sm = SceneManager()
    sm.add_detector(ContentDetector(threshold=threshold, min_scene_len=min_scene_len))
    sm.detect_scenes(video, show_progress=False)

    scenes = [(s.get_seconds(), e.get_seconds()) for s, e in sm.get_scene_list()]
    return scenes, total
-
탐지 뒤 후처리 3단계를 거친다.
-
병합 : 1초 미만 조각은 이웃에 붙인다.
-
분할 : 15초 넘는 조각은 균등하게 나눈다. (페이드·디졸브를 놓쳤을 때의 안전장치)
-
스냅 : 경계를 0.1초 단위로 맞춘다.
-
-
컷마다 시작 시각을 올림한 "초" 를 번호로 붙인다.
- 이 번호가 1번 단계의 프레임 파일 번호와 같다.
-
동작 기록
2026-09-18 17:32:44[INFO] [v1029/VOD] scene_manager.py:575 | Detecting scenes...
2026-09-18 17:34:11[INFO] [v1029/VOD] detect.py:70 | 분할 탐지: VOD.mp4 (threshold=15.0, fps=29.97) → 원시 장면 1172개 / 총 3711.8s
2026-09-18 17:34:11[INFO] [v1029/VOD] detect.py:234 | 분할 후처리: 원시 1172개 → 병합 1172개 → 분할 1184개 → 타일 1184개 (총 3711.8s, 오프셋 0s)
2026-09-18 17:34:50[INFO] [v1029/VOD] vision.py:122 | t_vision 등록: 1184행
2026-09-18 17:34:50[INFO] [v1029/VOD] pipeline.py:109 | prep 완료: 세그 1184개 오프셋 0s (총 126.7s = 분할 87.1 + 등록 39.6)
- 62분 회차에서 컷 1,184개, 약 2분이 걸린다.
- 예시 입출력
입력:  VOD.mp4
출력:  [(0, 0.0, 1.6), (2, 1.6, 3.0), (3, 3.0, 7.9), (8, 7.9, 12.9), ...]   ← (번호, 시작초, 끝초)
5. 컷 판정 (Qwen3.8-27B)
- 컷마다 LLM 을 한 번씩 부른다. 한 회차에 1,200~1,300번이다.
- 넣는 것은 컷의 첫 프레임 1장 과 그 구간의 대사 다.
## agent-vision/src/domains/drama/stages/vision/prompts.py

SCENE_TYPES: dict[str, str] = {
    "DIALOGUE": "두 명 이상의 인물이 마주보고 대화하는 화면. 숏/리버스숏도 대화 중이면 여기.",
    "CLOSEUP": "한 인물의 얼굴·상반신을 크게 잡은 화면. 표정·감정이 중심이고 대화 상대가 프레임에 없다.",
    "ACTION": "인물이 이동하거나 행동하는 화면 — 걷기·달리기·운전·싸움·작업 등 움직임이 중심.",
    "ESTABLISHING": "장소·풍경·건물·거리의 전경. 인물이 없거나 작게 보이고 '어디인가'를 보여주는 화면.",
    "GRAPHIC": "타이틀·엔딩 크레딧·자막 그래픽 전면·검은 화면 등 실사 장면이 아닌 화면.",
    "AD": "드라마 화면이 아닌 상업 광고.",
    "ETC": "위 유형에 속하지 않는 기타 화면.",
}

SCENE_MAX_TOKENS = 120   # 설명 한 문장 + 유형 한 단어


def scene_content(root, v_id, stream_id, secs, text) -> list[dict]:
    return [
        {"type": "text", "text": text},                       # 텍스트를 먼저
        *({"type": "image_url", "image_url": {"url": frame_url(root, v_id, stream_id, s)}}
          for s in secs),                                     # file:// 경로
        {"type": "text", "text": "이 화면의 설명과 유형은?"},
    ]
- 프롬프트에 넣는 텍스트는 컷의 시각과 그 안에서 시작한 대사다. (형식 예시)
[장면] 00:12:03 ~ 00:12:07
[대사] 00:12:04 그 얘기는 나중에 하자
- 응답은 정확히 2줄 로 고정했다.
사무실 책상 앞에서 정장 차림의 남자와 여자가 마주 앉아 서류를 두고 이야기한다
DIALOGUE
## agent-vision/src/domains/drama/stages/vision/prompts.py

def parse(text: str) -> tuple[str | None, str]:
    lines = [_LABEL.sub("", ln).strip() for ln in (text or "").strip().splitlines()]
    lines = [ln for ln in lines if ln]
    if not lines:
        return None, ""
    tail, body = lines[-1], lines[:-1]
    for name in sorted(SCENE_TYPES, key=len, reverse=True):
        if name in tail:                       # 유형은 마지막 줄에서만 찾는다
            return name, " ".join(body) or tail
    return None, " ".join(lines)
-
이미지는
file://경로로만 넘긴다.- base64 로 싣지 않는다. 추론 서버가 자기 디스크에서 직접 읽는다.
-
텍스트를 이미지보다 앞에 둔다.
- 뒤에 붙이면 모델이 마지막 프레임만 보고 답하는 쏠림이 있었다.
-
화면이 먼저, 대사는 보조다.
- 대사를 읽고 화면에 없는 것을 지어내지 않게 프롬프트에 명시했다.
-
유형은 마지막 줄에서만 읽는다.
- 설명 문장에 유형 이름이 섞여도 오염되지 않는다.
-
결론
-
유형 밖 응답은
ETC로 넣는다. 다시 물어도 같은 답이 온다. -
호출이 실패한 컷은 비워 둔다. 다음 실행 때 빈 컷만 자동으로 다시 판정한다.
-
-
1,315건을 한꺼번에 띄우고 동시 전송 수만 제한했다. 한 회차에 약 3분 30초 가 걸렸다.
-
결과 확인
# 컷 (t_vision)
idx_sec  start_time  end_time    scene_type  summary
654      00:10:53.5  00:11:01.7  ACTION      고급 주택 현관 앞에서 검은 정장 남자가 서 있다가, 베이지 정장 남자가 문을 나서 ...
662      00:11:01.7  00:11:05.2  DIALOGUE    베이지색 정장을 입은 남자가 무표정하게 바라보다가, 이어 침대에 앉아 있는 여자와 ...
675      00:11:14.2  00:11:16.7  CLOSEUP     베이지색 정장에 검은 넥타이를 매고 가슴에 금색 핀을 단 남자가 눈을 감은 채 서 있다
6. 씬 묶기 (Qwen3.8-27B)
- 컷은 평균 3초짜리 조각이다. 숏폼 재료로 쓰기엔 너무 잘다.
- 이어지는 컷을 "같은 장소에서 벌어지는 한 사건" 인 씬으로 묶어야 한다.
- 묶는 판단은 LLM 이 한다. 입력은 이미지가 아니라 5번에서 나온 컷 설명과 대사 텍스트 다.
이 시기에는 "컷 1,300줄을 어떻게 나눠서 물을 것인가" 를 두고 두 가지를 시험하였다.
| 시기 | 방법 | 한 번에 넣는 글 |
|---|---|---|
| 09-17 | 잘게 잘라 70여 번에 나눠 물음 | 약 1,000 토큰 |
| 09-29 | 크게 뭉쳐 5~16번만 물음 | 1만 토큰대 |
- 잘게 자르면 조각마다 앞뒤 문맥이 부족하다.
- 크게 뭉치면 한 번에 읽어야 할 양이 너무 많다.
- 씬 테이블의 첫 형태
# 씬 (t_scene_drama)
scene_seq   씬 순번
start_sec   시작 초
end_sec     끝 초
scene_type  본편 / 회상 / recap
place       장소
speakers    그 구간에서 말한 화자 번호 목록 (S001,S003)
cast        화자 번호별 외형 묘사 (S003=정장 차림 남자)
summary     씬 요약
- 이 시기에는 두 회차만 씬까지 만들었다.
마무리
음성에서 대사·요약을, 화면에서 컷·화면 유형을 뽑는 과정까지 완료되었다.
씬 묶기는 방법을 정하지 못한 채 시험 단계에 머물렀고, 화자도 S005 같은 번호로만 구분되는 것이 확인되었다.
추후 회차를 사건 단위로 먼저 나눈 뒤 씬을 묶는 구조와, 화자 번호에 배역 이름을 붙이는 작업을 진행할 예정이다.
참고 링크)
- https://www.scenedetect.com/docs/latest/
- https://docs.vllm.ai/
- https://github.com/pyannote/pyannote-audio
본 글은 과학기술정보통신부·정보통신산업진흥원 「2026년 오픈소스 AI·SW 개발·활용 지원사업」의 지원으로 수행된 연구 결과입니다.