모아보기 서비스 구현기 1건

들어가며
드라마 여러 회차에서 한 주제의 장면을 골라 모으는 모아보기를, 질의 한 줄로 만드는 과정을 정리한 글이다.
숏폼 2편에서는 1회차 안에서 씬을 골라 3분 요약을 만들었다.
모아보기는 주제 하나를 정해 그 주제의 장면을 모으는 것 이다. 주제는 두 갈래다.
| 갈래 | 주제 | 질의 예 |
|---|---|---|
| 줄거리 모아보기 | 회차 범위의 이야기 | 모아보기 20분 요약 (1~2화), 1시간 모아보기 (1~10화) |
| 장면 모아보기 | 인물·행동·대사 | 김부장 주인공 격투 액션 모음집, 박진철 싸움 장면 2분 |
숏폼과 달라지는 것은 범위와 분량이다.
| 구분 | 숏폼 | 모아보기 |
|---|---|---|
| 범위 | 1회차 | 1회차 ~ 여러 회차 (이 글은 2회차, 10회차) |
| 분량 | 30초 ~ 3분 | 2분 ~ 1시간 |
| 클립 수 | 1 ~ 12개 | 1 ~ 470개 |
별도 서비스를 새로 만든 것은 아니다. 숏폼과 같은 편성 API 를 쓰고, 묶는 회차와 질의, 목표 분량만 다르다.
POST /api/v1/compose
{
  "query": "모아보기 20분 요약",
  "budget_sec": 1200
}
전체 흐름을 그림으로 나타내면 아래와 같다.
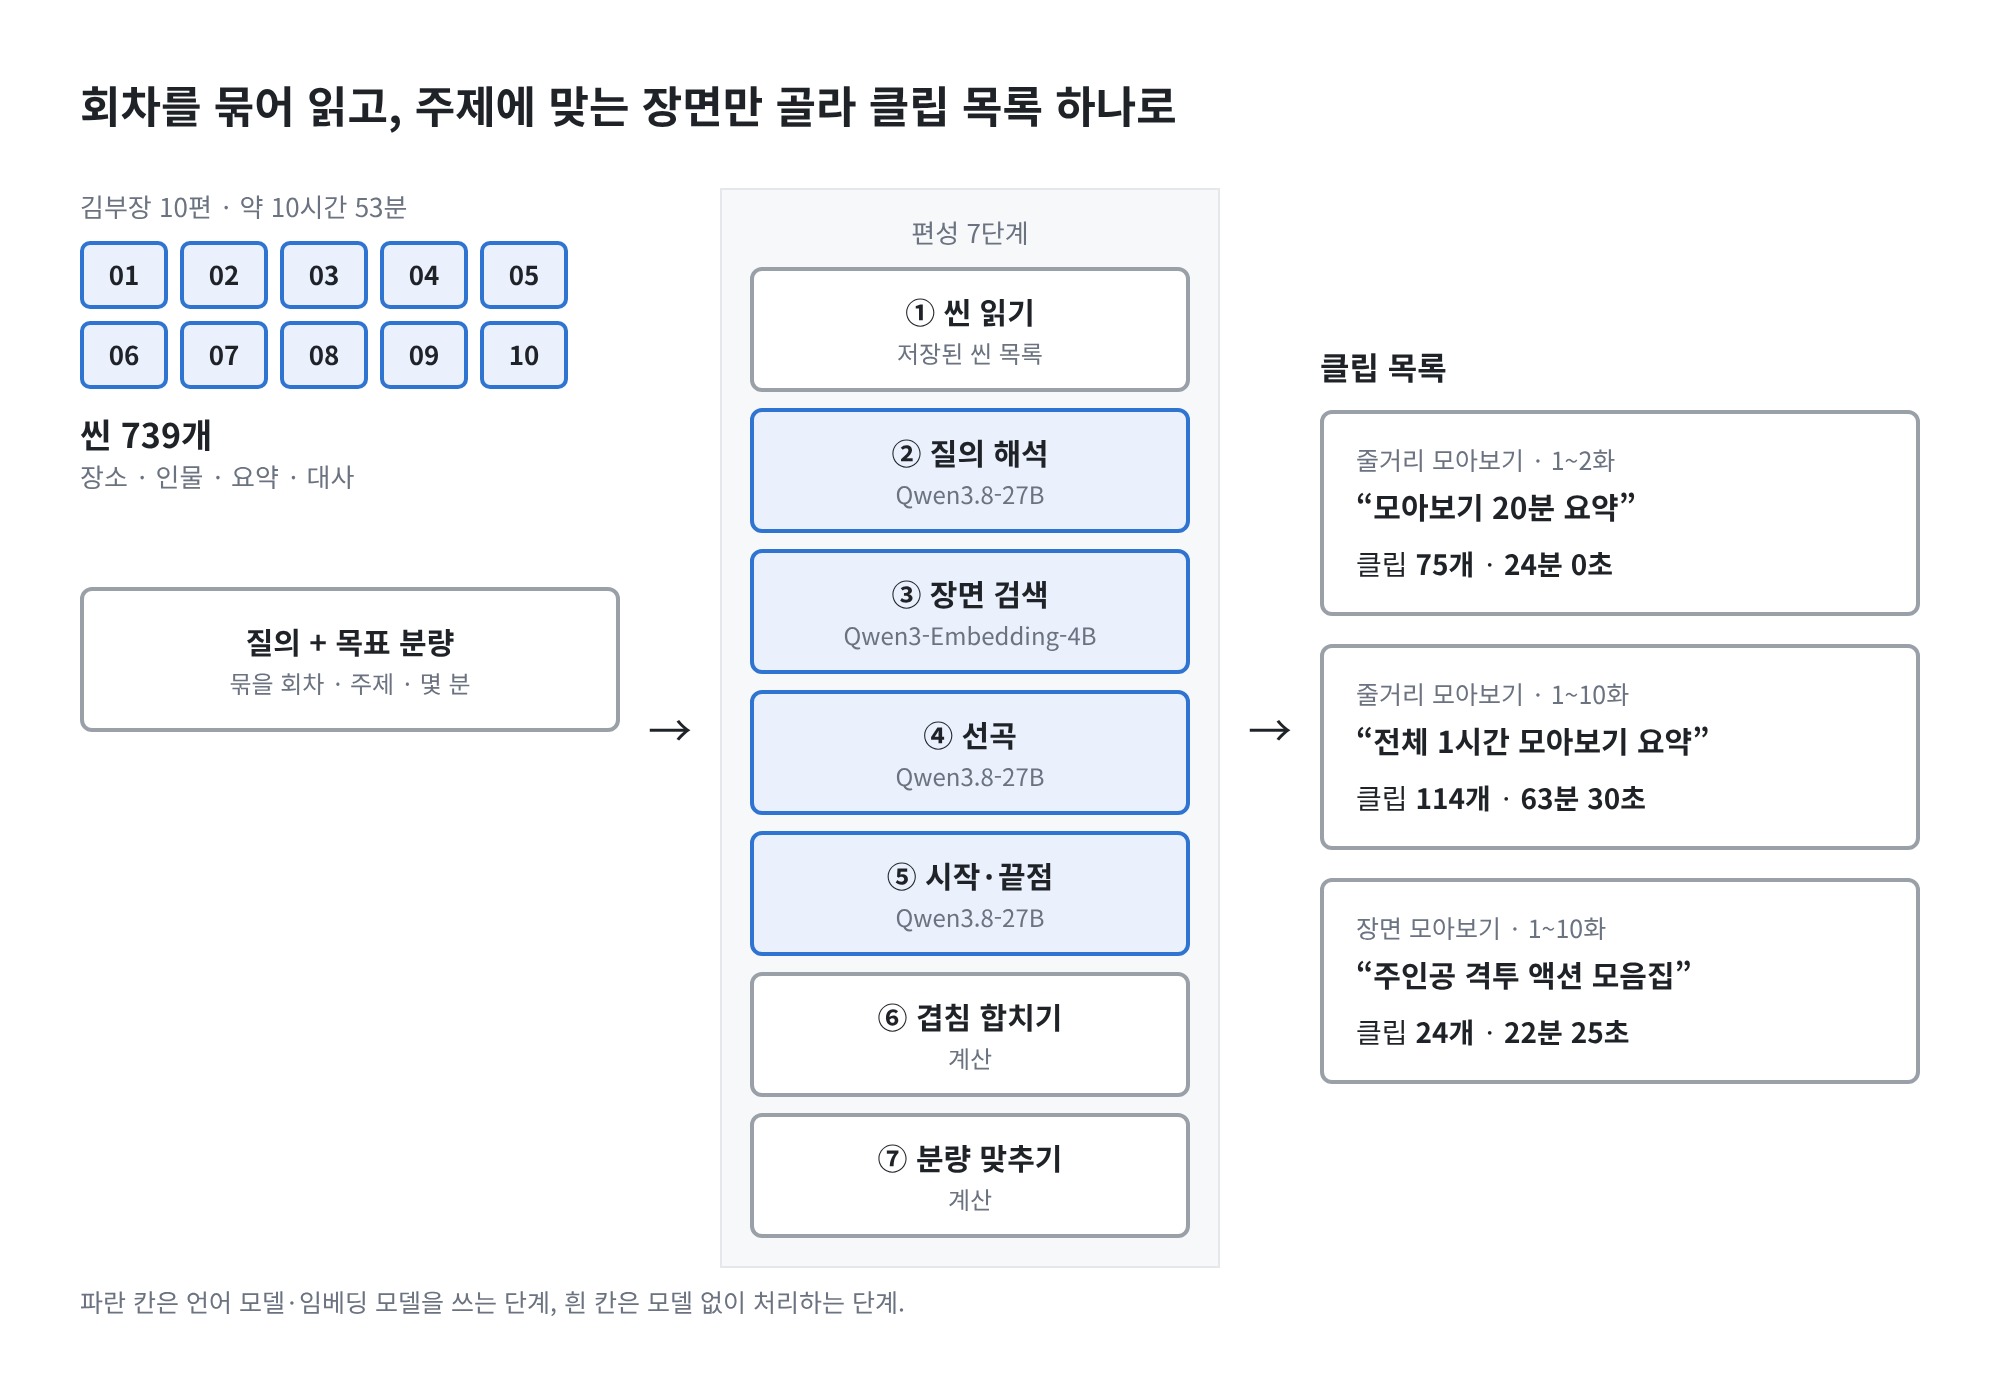
단계별로 사용한 모델이다. 숏폼 편성과 같다.
| 단계 | 모델 | 입력 |
|---|---|---|
| ① 씬 읽기 | 없음 (DB) | — |
| ② 질의 해석 | Qwen3.8-27B-FP8 | 글자 |
| ③ 장면 검색 | Qwen3-Embedding-4B | 글자 |
| ④ 선곡 | Qwen3.8-27B-FP8 | 글자 |
| ⑤ 시작·끝점 | Qwen3.8-27B-FP8 | 글자 |
| ⑥ 겹침 합치기 · ⑦ 분량 맞추기 | 없음 (계산) | — |
편성 단계는 화면을 다시 보지 않는다. 씬에 붙어 있는 장소·인물·요약과 대사, 곧 글자만 읽는다.
이 글에서 다루는 내용은 아래와 같다.
- 재료 — 씬과 검색 색인
- 회차를 묶는 구조
- 편성 7단계
- 줄거리 모아보기
- 장면 모아보기
- 분량 맞추기
1. 재료 — 씬과 검색 색인
- 대상은 SBS 드라마 「김부장」 10편이다. 전체 길이는 약 10시간 53분 이다.
- 편성이 고르는 단위는 씬 이다. 같은 시간·장소에서 이어지는 한 장면이고, 씬마다 장소·인물·요약이 붙어 있다.
- 10편에 씬이 739개 있다. 모아보기는 이 중에서 쓸 것을 고르는 일이다.
- 질의와 비슷한 장면을 찾기 위해 검색용 색인을 둔다.
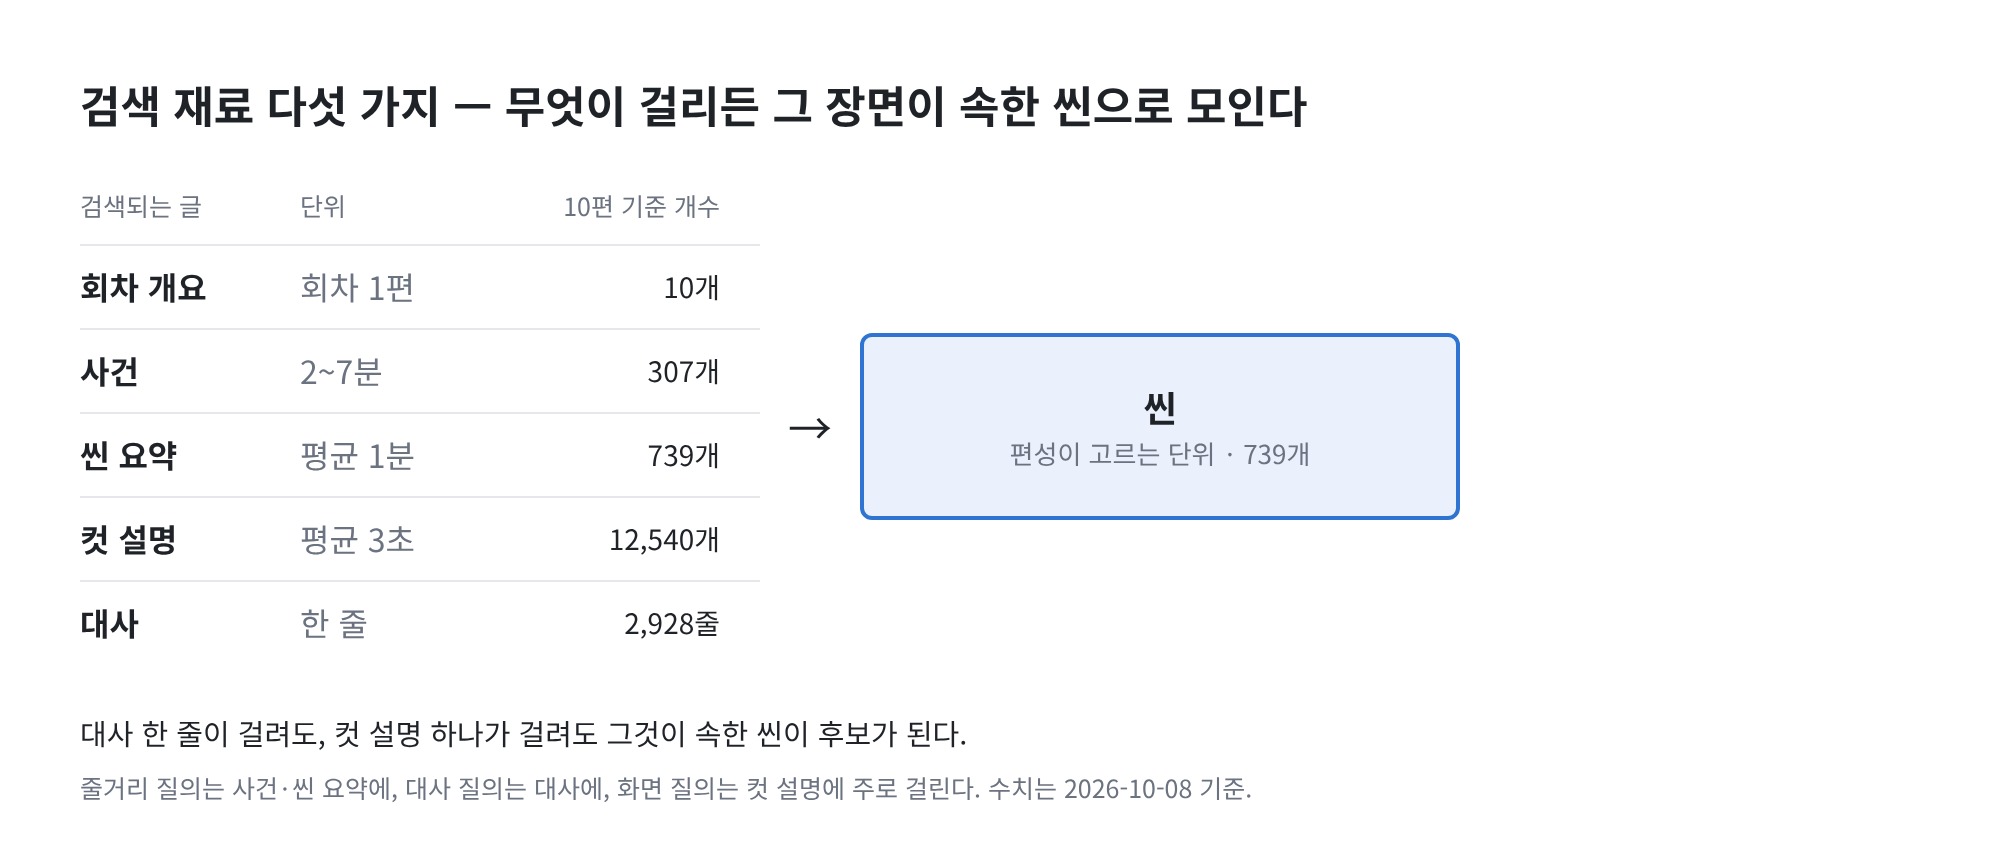
- 큰 단위(회차 개요)부터 작은 단위(대사 한 줄)까지 다섯 가지 글이 들어 있다.
-
무엇이 검색에 걸리든 씬으로 모인다.
- 대사 한 줄이 걸리면, 그 대사가 속한 씬이 후보로 올라온다.
-
줄거리를 묻든, 대사를 묻든, 화면을 묻든 같은 색인에서 찾는다. 질의 종류를 미리 가르지 않는다.
2. 회차를 묶는 구조
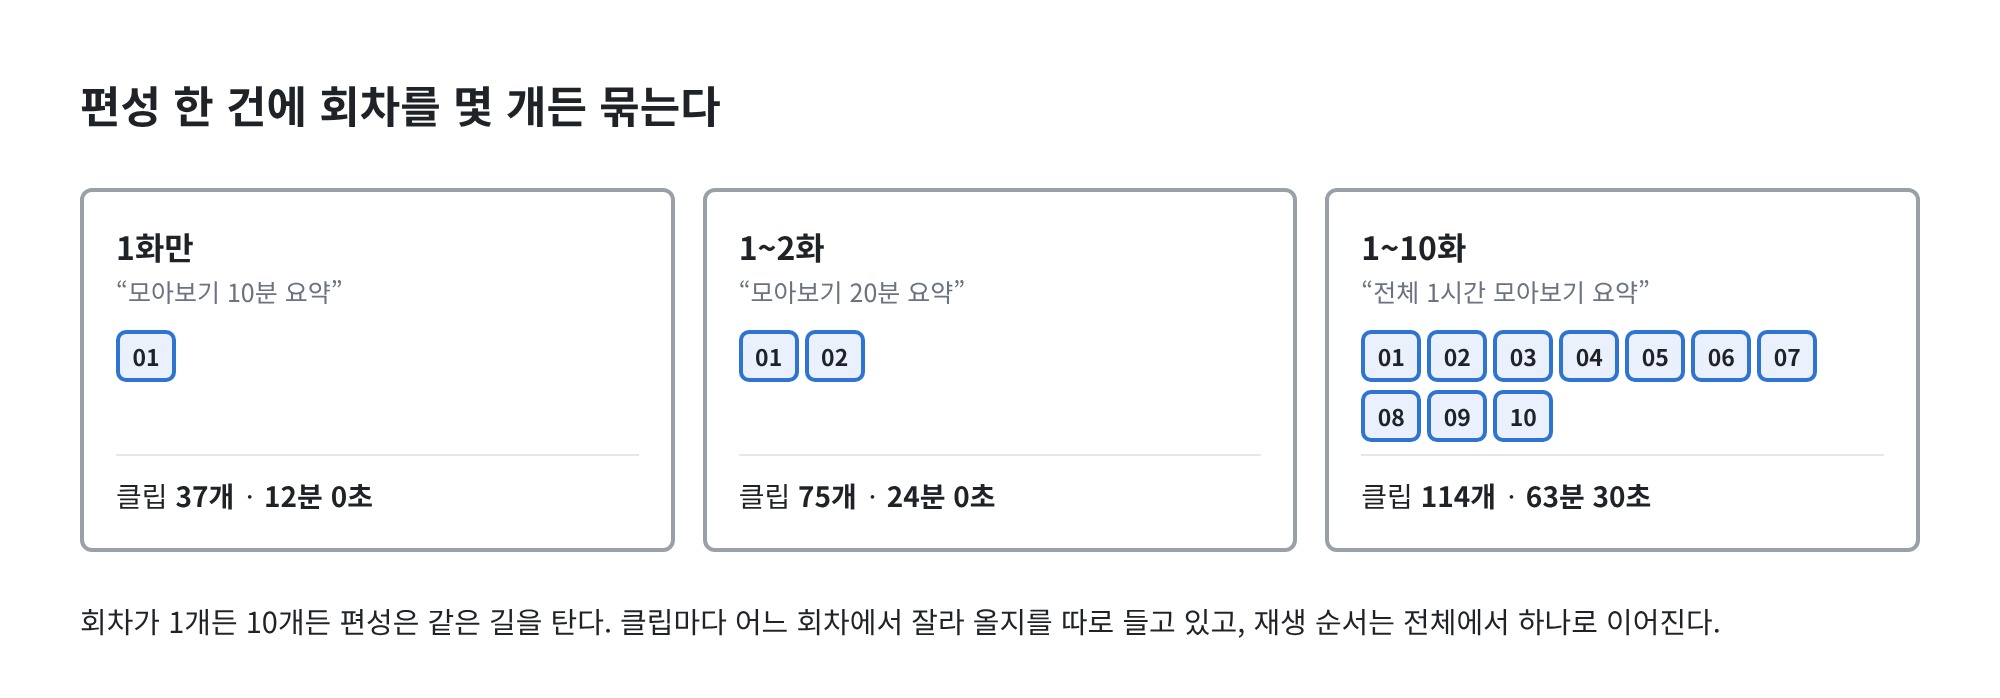
- 편성 한 건에 회차를 몇 개든 묶을 수 있다. 1화만, 1~2화, 1~10화 전부 같은 방식이다.
-
편성 한 건은 세 가지 정보로 이루어진다.
-
편성 — 질의, 목표 분량, 결과 길이, 클립 수
-
묶인 회차 — 이 편성이 읽을 회차 목록
-
클립 — 재생 순서, 잘라 올 회차, 시작 초와 끝 초
-
-
클립마다 어느 회차에서 잘라 올지가 적혀 있다.
- 재생 순서는 편성 전체에서 하나로 이어진다. 1화 클립이 끝나면 2화 클립이 이어서 나온다.
-
회차가 1개든 10개든 편성 과정은 같다. 묶인 회차 목록만 길어진다.
3. 편성 7단계 (Qwen3-Embedding-4B, Qwen3.8-27B)
- 편성은 요청을 접수만 하고 바로 응답 한다. 실제 작업은 뒤에서 돌고, 끝났는지는 진행 상태를 조회해 확인한다.
- 한 번에 한 건만 돈다. 진행 중에 또 요청하면 거절한다.
- 작업은 7단계가 한 줄로 이어진다.
| 단계 | 하는 일 |
|---|---|
| ① 씬 읽기 | 묶인 회차의 씬 목록을 가져온다 |
| ② 질의 해석 | 누구 · 무엇 · 몇 분인지 읽는다 |
| ③ 장면 검색 | 색인에서 질의와 비슷한 씬을 찾는다 |
| ④ 선곡 | 후보 중 쓸 씬을 고르고 중요도 순위를 매긴다 |
| ⑤ 시작·끝점 | 씬 안에서 쓸 구간을 정한다 |
| ⑥ 겹침 합치기 | 겹치는 클립을 하나로 합친다 |
| ⑦ 분량 맞추기 | 목표 길이에 맞춰 덜어낸다 |
- 질의에 맞는 씬이 없으면 빈 결과 로 끝난다. 오류가 아니다. 없는 장면을 억지로 뽑지 않는다.
3-1. 걸리는 시간
- 회차를 묶으면 후보 씬이 많아진다. 10편을 묶으면 739개다.
- 그래도 편성 한 건은 몇 분 안에 끝난다.
| 범위 | 질의 | 걸린 시간 |
|---|---|---|
| 1화 | 스토리 전체 3분 요약 | 51초 |
| 1~2화 | 모아보기 20분 요약 | 1분 21초 |
| 1~10화 | 드라마 김부장 전체 1시간 모아보기 요약 | 3분 47초 |
- 원본 약 11시간을 읽어 1시간 모아보기 목록을 만드는 데 3분 47초 가 걸렸다.
4. 줄거리 모아보기
- 회차 범위를 정하고, 그 범위의 이야기를 목표 분량으로 줄인다.
- 질의에는 주제와 분량만 쓴다. ("모아보기 20분 요약")
- 이야기 전체가 주제이므로 묶인 회차의 모든 씬이 후보 가 된다.
- 결과는 짧은 클립 여러 개다. 회차 순서대로, 회차 안에서는 시간 순서대로 이어진다.
4-1. 1~2화를 20분으로
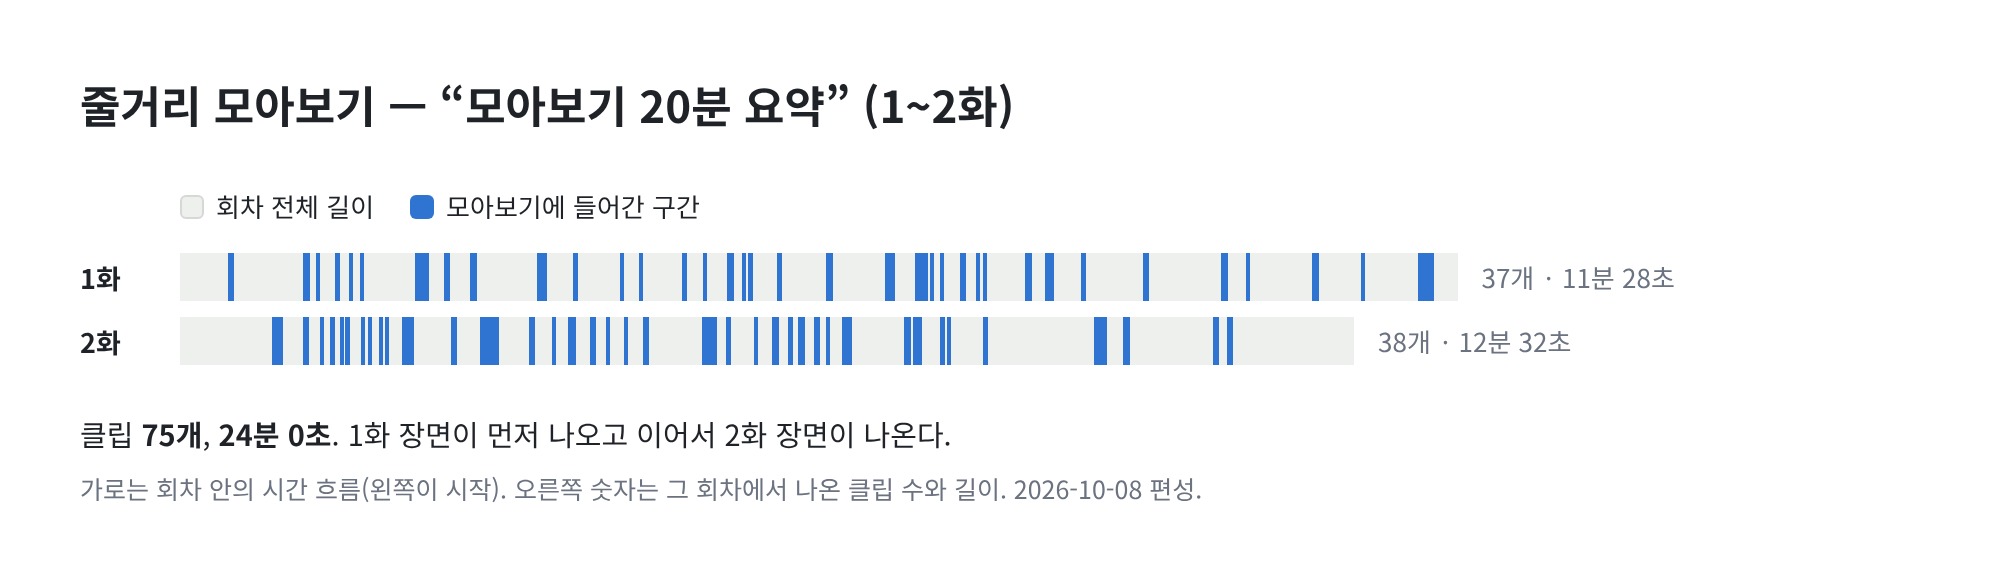
- 1화와 2화를 묶어 요청하면 클립 75개, 24분 0초가 나온다.
- 1화에서 37개, 2화에서 38개가 나온다. 두 회차가 거의 반씩 들어간다.
- 클립 하나는 평균 19초다. 회차 처음부터 끝까지 고르게 짚는다.
4-2. 1~10화를 1시간으로
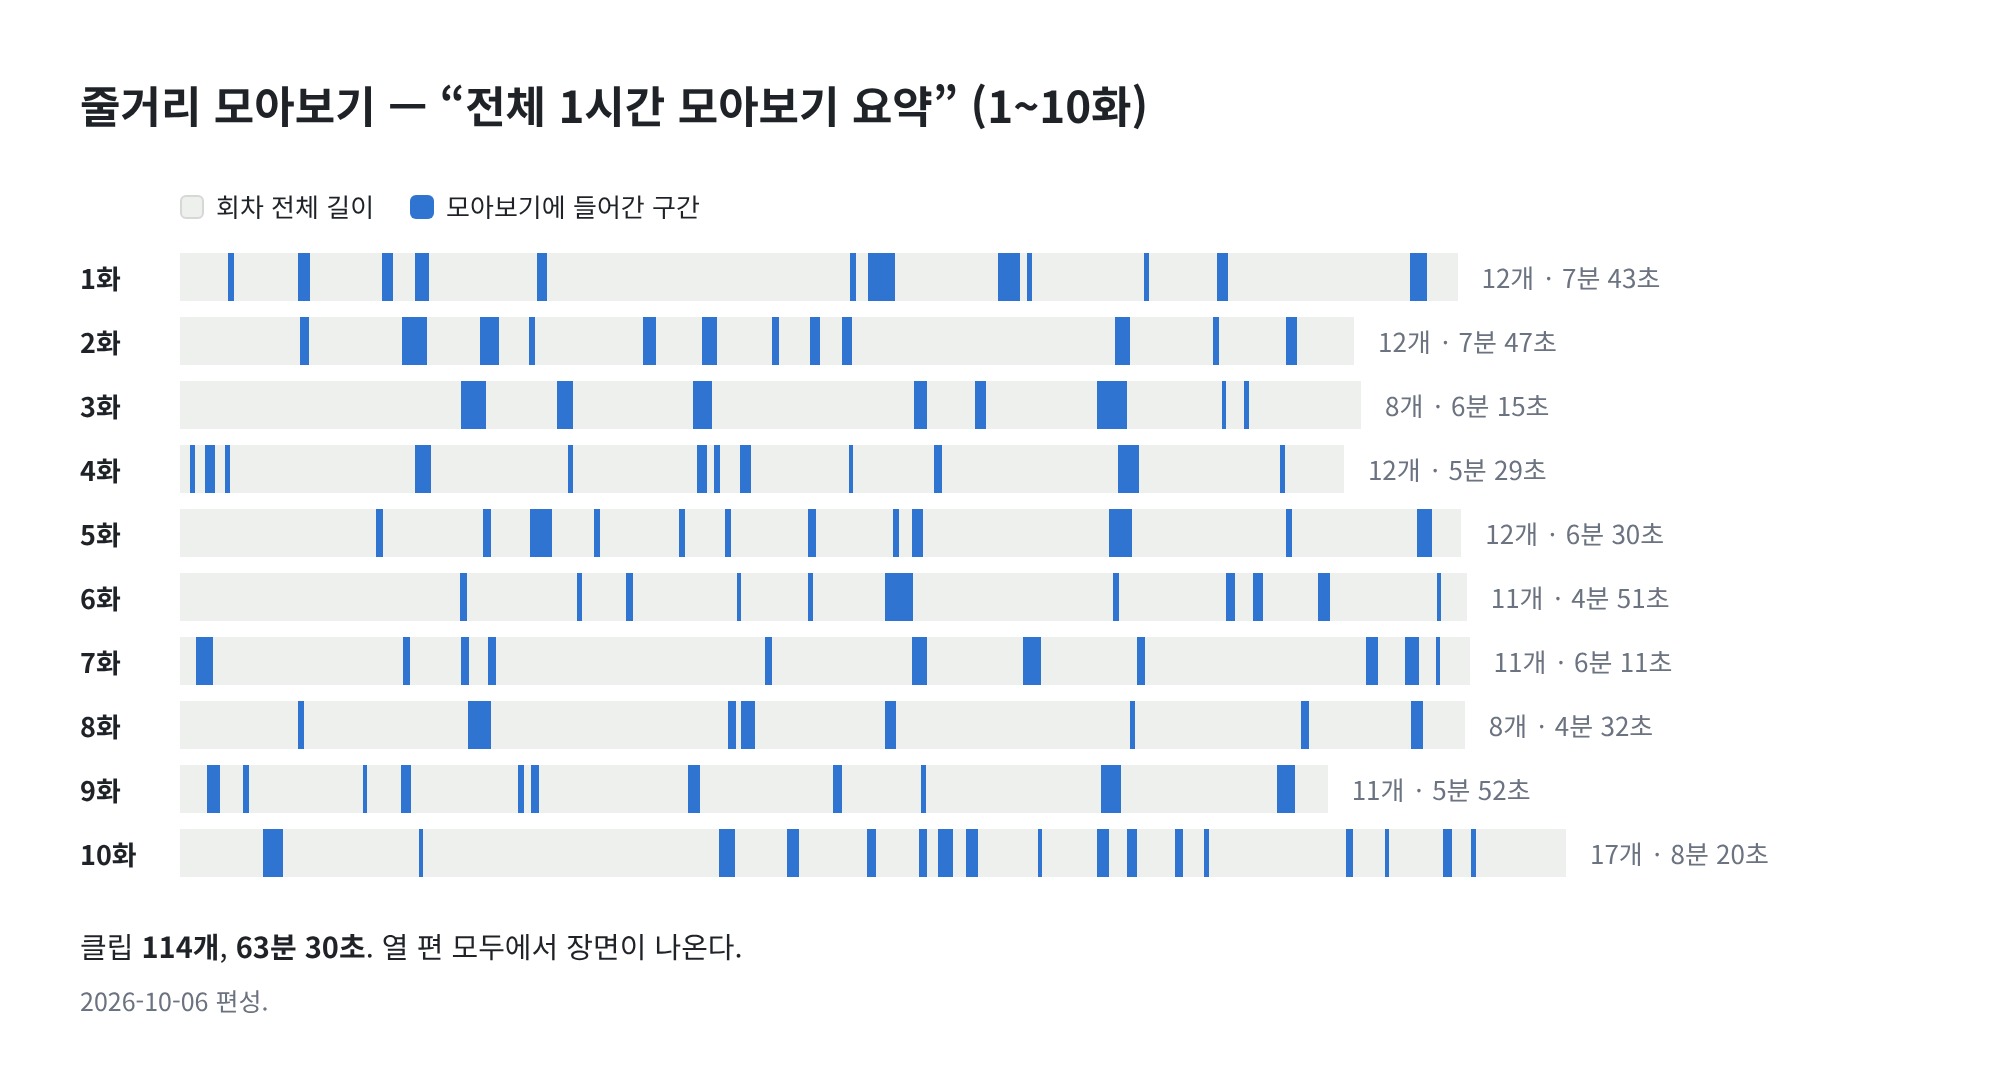
- 10편을 묶어 요청하면 클립 114개, 63분 30초가 나온다.
- 열 편 모두에서 장면이 나온다. 회차마다 8~17개다.
- 클립 하나는 평균 33초다.
- 같은 방식으로 10편을 10분으로 줄일 수도 있다. 이때는 클립 27개, 11분 57초가 나온다.
- 줄거리 모아보기는 목표 분량을 함께 줘야 한다.
- 목표가 없으면 후보가 모두 살아남아 결과가 몇 시간으로 길어진다.
5. 장면 모아보기
- 인물·행동·대사로 주제를 좁혀 그 장면만 모은다.
- 질의에는 찾을 장면을 쓴다. ("김부장 주인공 격투 액션 모음집", "민지 싸우는 장면")
- 주제에 맞는 씬만 후보 가 된다. 줄거리 모아보기와 같은 7단계를 타지만, 검색 단계에서 후보가 크게 줄어든다.
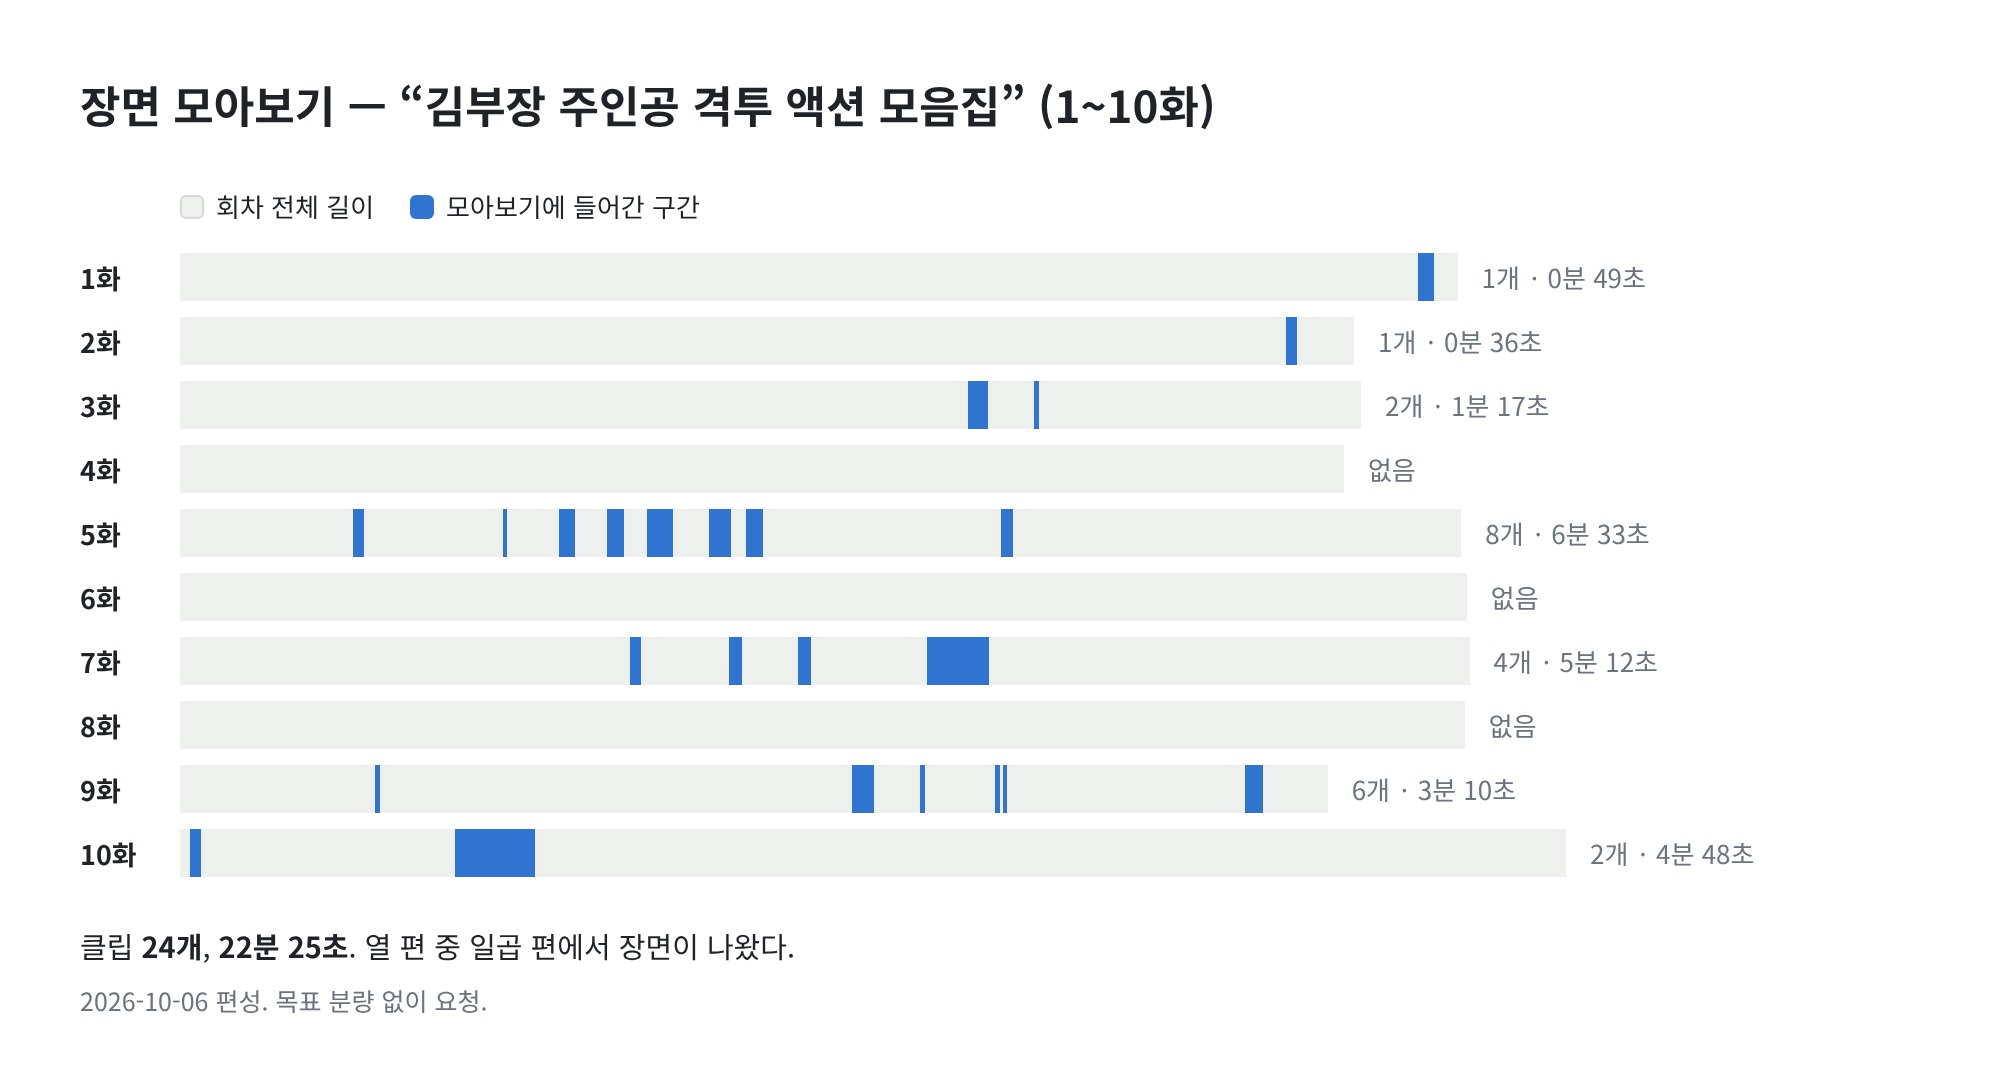
- 10편을 묶어 격투 장면을 요청하면 클립 24개, 22분 25초가 나온다.
- 장면이 있는 회차에서만 나온다. 5화에서 8개가 나왔고, 4화·6화·8화에서는 나오지 않았다.
- 클립 하나는 평균 56초다. 격투는 시작부터 끝까지 이어져야 장면이 되므로 구간이 길게 잡힌다.
- 목표 분량을 주지 않아도 된다. 주제에 맞는 장면을 다 모으면 거기서 끝난다.
- 그 밖의 동작은 아래와 같다.
| 질의에 쓴 것 | 동작 | 예 |
|---|---|---|
| 장면 하나 | 그 장면만 클립 1개로 낸다 | 김부장 마지막 싸움 장면 → 1개, 3분 38초 |
| 대사 | 그 대사가 나오는 구간을 낸다 | 민지 아빠가 간첩이었다고 알려주는 대사 → 1개, 19초 |
| 개수 | 쓴 개수만큼 낸다 | 격투 장면 최고의 모음집 10개 → 10개 |
| 없는 장면 | 빈 결과로 끝난다 | 민지가 바다에서 수영하는 장면 → 0개 |
6. 분량 맞추기
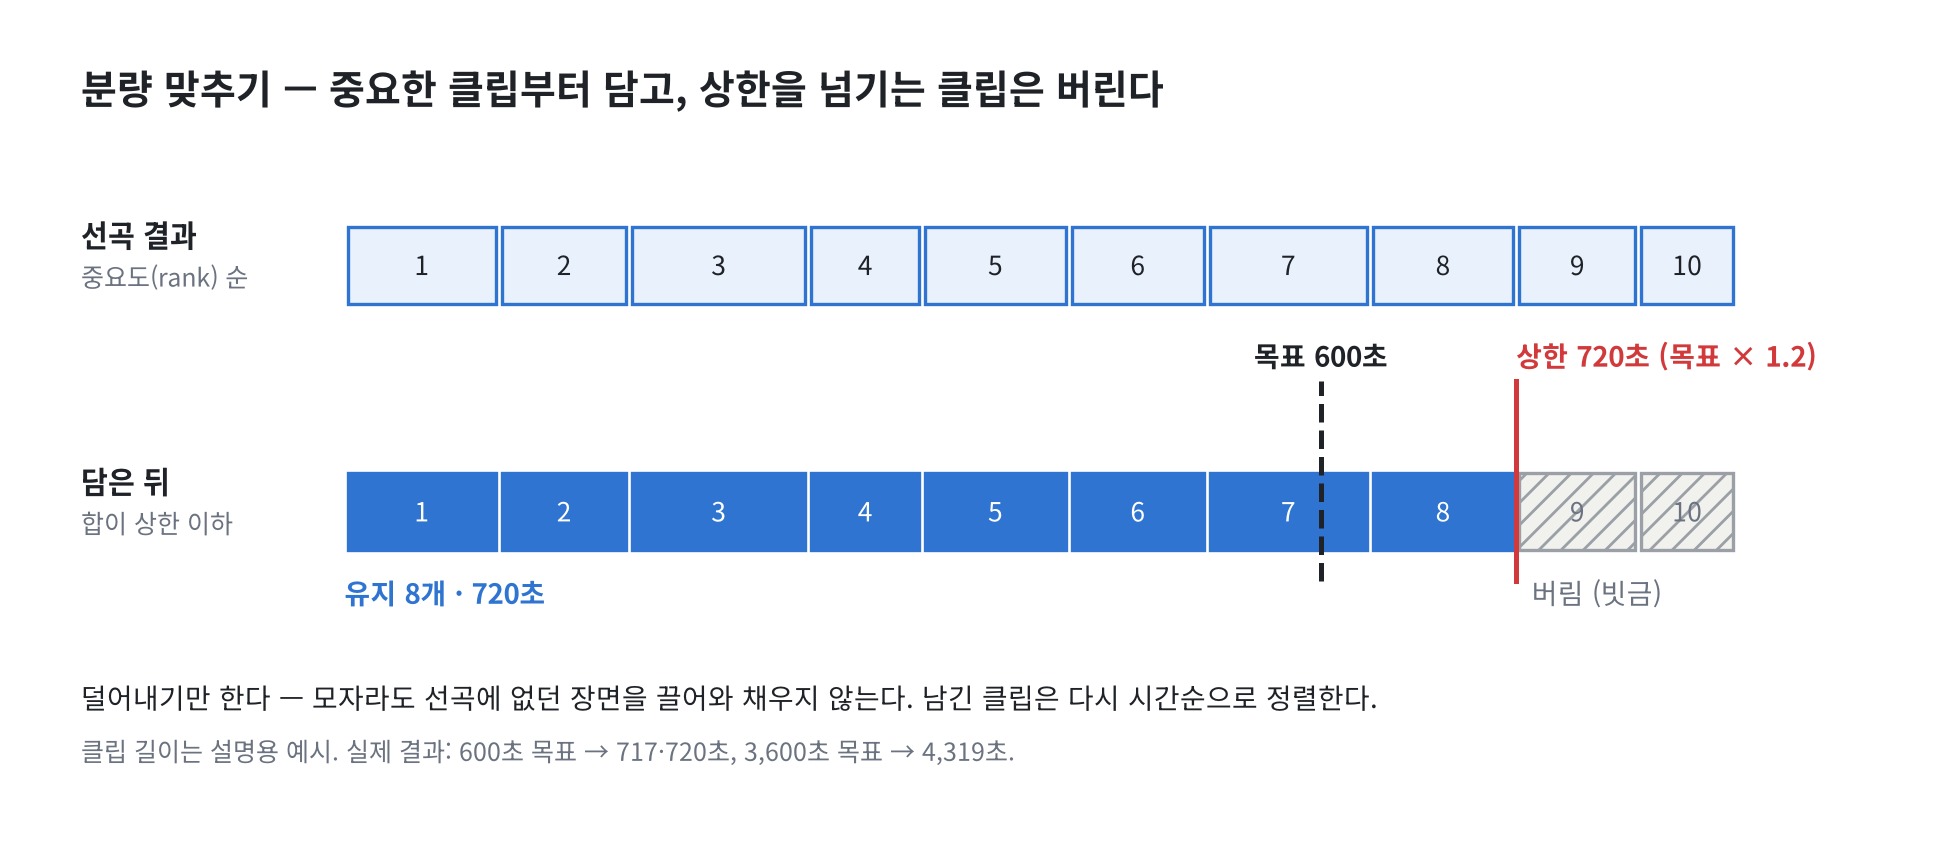
- 목표 분량은 언어 모델에게 계산시키지 않는다. 선곡 단계는 중요도 순위만 매기고, 덜어내는 산수는 코드가 한다.
-
규칙은 세 가지다.
-
중요한 클립부터 담는다.
-
상한을 넘기는 클립은 버린다.
-
덜어내기만 한다. 모자라도 선곡에 없던 장면을 끌어와 채우지 않는다.
-
-
상한은 목표보다 조금 길게 잡혀 있다.
-
딱 맞춰 자르면 대체로 목표보다 짧게 끝나기 때문에 여유를 둔 것이다.
-
지금 결과는 목표의 120% 에서 끝난다. 10분을 요청하면 12분, 20분을 요청하면 24분이 나온다.
-
-
담을 때는 중요도 순, 내보낼 때는 시간순 이다. 모아보기는 이야기 순서대로 재생돼야 한다.
마무리
「김부장」 10편(약 10시간 53분, 씬 739개)에서 질의 한 줄로 주제에 맞는 장면을 모아 클립 목록으로 만드는 과정까지 완료되었다.
현재 구성을 정리하면 아래와 같다.
- 숏폼과 같은 편성 7단계를 쓴다. 묶는 회차와 질의, 목표 분량만 다르다.
- 편성 한 건에 회차를 1개부터 10개까지 묶을 수 있다.
- 줄거리 모아보기와 장면 모아보기를 같은 과정으로 만든다.
- 1~2화 20분 모아보기는 1분 21초, 1~10화 1시간 모아보기는 3분 47초가 걸린다.
아직 남아 있는 부분은 아래와 같다.
- 결과는 클립 목록까지다. 목록을 한 편의 영상으로 합치는 과정은 연결되지 않았다.
- 결과 길이가 목표의 120% 까지 나온다.
- 같은 질의라도 실행할 때마다 회차별 배분이 달라질 수 있다.
영상으로 합치는 과정과 분량·배분을 다듬는 작업은 추후 진행할 예정이다.
참고 링크)
- https://langchain-ai.github.io/langgraph/
- https://milvus.io/docs
- https://huggingface.co/Qwen/Qwen3-Embedding-4B
- https://docs.vllm.ai/
본 글은 과학기술정보통신부·정보통신산업진흥원 「2026년 오픈소스 AI·SW 개발·활용 지원사업」의 지원으로 수행된 연구 결과입니다.